ローカルでOpus 5級のLLM? MiMo-V2.6を試した〜マルチGPUで大きなモデルも動いた
スマートフォンで知られる Xiaomi が、9月に自社のAIの中身を丸ごと公開しました。AIが学習して身につけた数値の集まり(「重み」と呼ばれます)をダウンロードできるので、手元のパソコンで動かすこともできます。1兆ものパラメータ(AIの大きさを表す数)を誇るモデルでありながら、無料で誰でも使えるとされています。
ただ、公開されたのは1つではなく4つです。そのうち、家のパソコンに入るのはどれなのでしょうか?
2026年9月時点の実測です。
Xiaomi製LLMのMiMo-V2.6とは?
Xiaomi は2026年9月21日(日本時間では22日の報道もあります)に、MiMo-V2.6 の名前で4つのモデルを出しました。Hugging Face の配布ページとモデルカードで確かめた内容です。
Hugging Face(ハギングフェイス)は、世界中の会社や個人がAIのモデルを公開・配布しているサイトです。手元で動かすAIの多くは、ここからダウンロードします。モデルカードは、そのモデルの配布ページの冒頭にある説明書のようなもので、作り手が大きさや成績、ライセンスを書いています。
| 名前 | 位置づけ |
|---|---|
| MiMo-V2.6-Pro(配布名 Pro-RL) | いちばん大きい本命。総パラメータ 1.02T(1兆)、1トークンで動くのは 42B |
| MiMo-V2.6-Flash(配布名 Flash-RL) | 軽いほう。総パラメータ 309B、1トークンで動くのは 15B |
| MiMo-V2.6-Distill-Qwen-9B(以下「9B」) | いちばん小さい。総パラメータ 約94億(9B) |
| MiMo-V2.6-Pro-UltraSpeed | Pro と同じ中身のまま、質問してから答えが返ってくるまでを速くした版。Xiaomi がネット上で提供するサービス(API)を通して使うもので、中身(重み)はダウンロードできない |
パラメータは、AIが学習で調整する数値(重み)の数で、多いほど大きなモデルです。B は10億を表し、309B は3,090億、42B は420億、15B は150億です。T は1兆です。トークンは、AIが文章を読み書きするときの細かな区切りの単位です。
4つのうち MiMo-V2.6-Distill-Qwen-9B だけは、Pro や Flash を小さくしたものではありません。Qwen3.5-9B という別のモデルを土台にして作られたものです(詳しくは後の節で書きます)。名前が長いので、以下では「9B」と呼びます。
Pro と Flash は、どちらも MoE(専門家を切り替えながら動く作り)で、全体は大きくても、1トークンを書くたびに動くのは一部だけです。一度に読ませられる文章の長さ(文脈の長さ)は100万トークンで、文字だけでなく画像・動画・音声も扱えるとモデルカードに書かれています。ライセンスは MIT です。
MIT というのは、商用利用も含めてほぼ制限なく使える形です。制限の少なさは大きい点です。
何が売りなのか?
公式のモデルカードの看板は「Scaling Reinforcement Learning Toward Self-Improvement」、強化学習(試しにやらせて、うまくいったやり方を強めていく学び方)を大きく回して、自分で伸びていくモデルを目指した、という言い方です。コーディング、エージェント(道具を使って作業をこなす使い方)、画像、サイバーセキュリティを、分野ごとに分けずに1回の強化学習でまとめて鍛えた、と説明しています。
Xiaomi の公式の X では、Pro が「ほとんどのエージェント系の試験で Claude Opus 5 や GPT-5.6 Sol と並ぶ」と打ち出しています。モデルカードの表には Flash の値も並んでいて、たとえば Terminal Bench 2.1 は Flash 87.6・Pro 89.9・Claude Opus 5 89.1、OSWorld-Verified は Flash 80.8・Pro 82.0・Claude Opus 5 83.4 です。
ただし、これらはすべて Xiaomi 自身が測った値で、Xiaomi が自作した試験も含まれます。第三者が同じ条件で確かめた値ではありません。
「Opus 5 並み」とうたっているのは Pro のほうですが、公式の配布ファイルは合計で約534GiB あり、有志が作った手元向けの圧縮版でも、いちばん小さいもので約220GiB あります。手元の EVO-X2(メモリ128GB)に外付けGPUの VRAM 28GB を足しても収まらないため、ローカルで動かすのは現実的ではありません。そこで今回は、軽いほうの Flash が動くかどうかに挑戦しました。Flash も強く圧縮した版で動かしているため、公式の値とは比べていません。
ローカルのPCで動くモデルは?
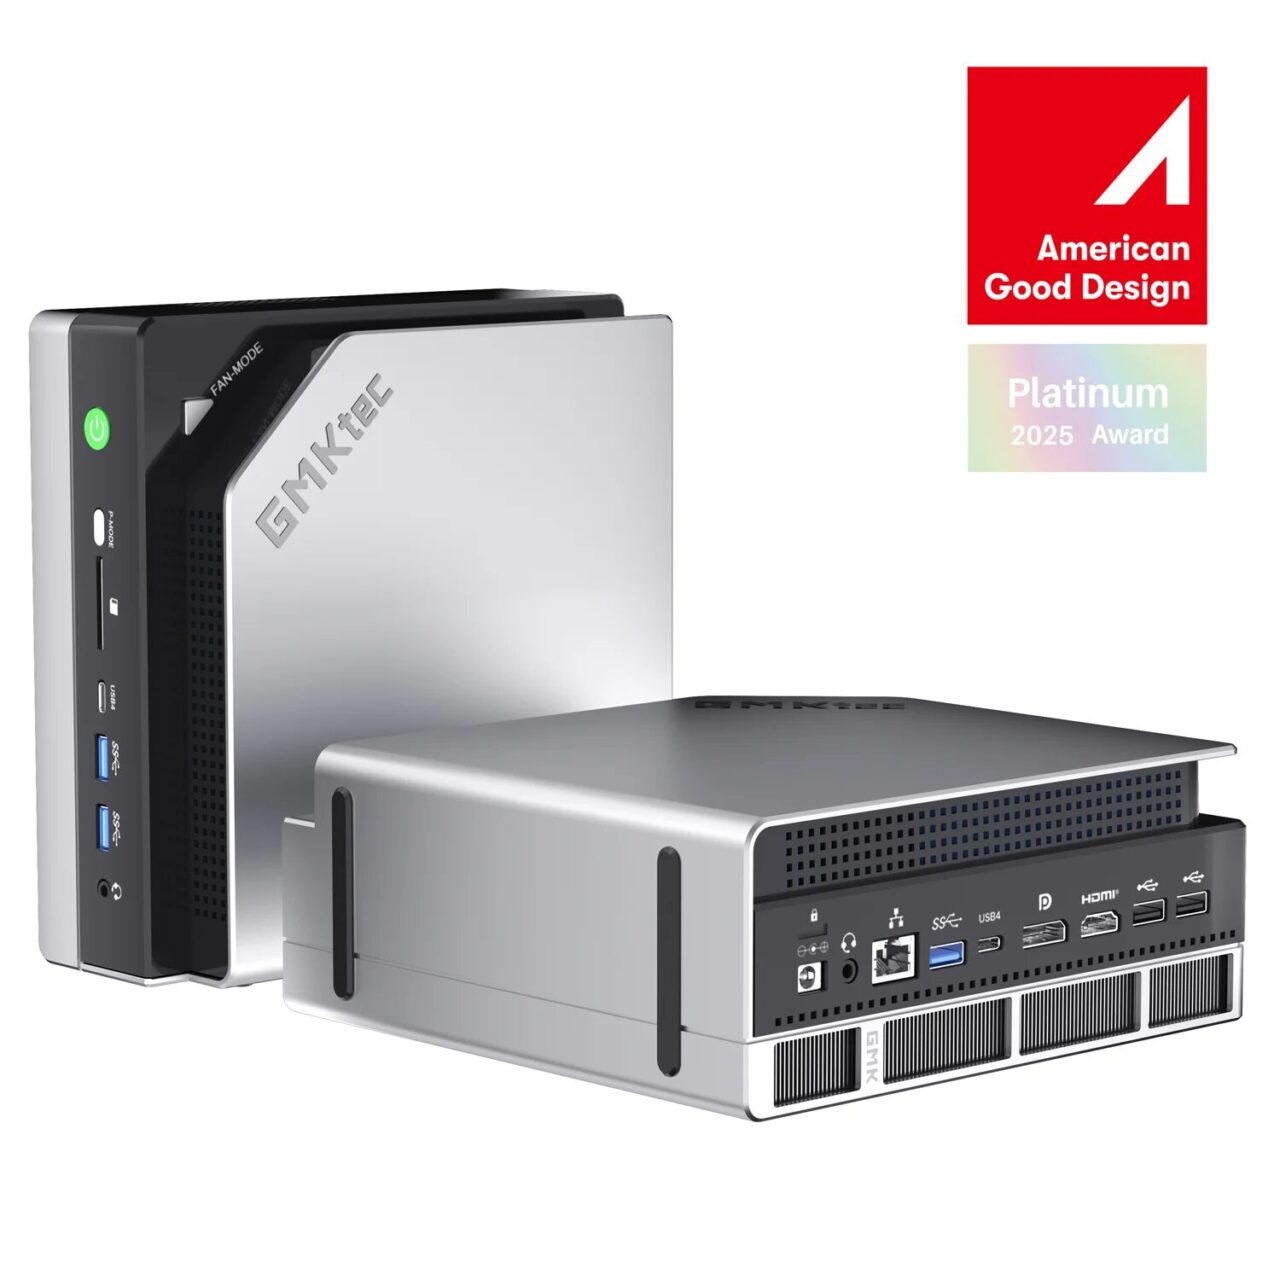
手元の機械は、128GBのユニファイドメモリを積んだミニPC、GMKtec EVO-X2 です(OSから見えるのは約122GiB)。ローカルAIを動かす目的では、かなり大きいほうの部類に入ります。
軽いほうの Flash について、配布されている圧縮版(量子化)の大きさを調べました。有志が公開しているファイルの一覧から並べたものです。
| 圧縮の形式 | ファイルの大きさ |
|---|---|
| MXFP4 | 155.9 GiB |
| Q3_K | 138 GiB |
| IQ3_XXS | 132 GiB |
| Q2_K(最小) | 117.1 GiB |
いちばん強く圧縮したもので117.1GiBです。OSから見えるメモリの約122GiBに対して、余白はほとんどありません。Q2_K はかなり強く削る形式で、一般には答えの質が落ちるとされています。
この Q2_K を、実際に EVO-X2 で動かしてみました。既定の設定のままでは起動の途中で落ち、設定を変えて動いても、書く速さは1秒あたり1〜2トークンほどで回ごとにぶれています。この EVO-X2 には、外付けのグラフィックボードが2枚(RTX 5060 Ti 16GB と RTX 3060 12GB)つないであります。グラフィックボードに載っているメモリ(VRAM)にモデルの一部を逃がし、残りを内蔵GPUに載せたところ、13.00 tok/s(1秒あたり13トークン)で安定して動きました。詳しくは後の節で書きます。
Pro(総パラメータ 1.02T)は、いちばん小さい圧縮版でも約220GiB で、手元の機械には収まらないため試していません。Pro-UltraSpeed は重みが配布されていないため、手元では動かせません。
残るのが9Bです。こちらは圧縮版で5.43GiBでした。容量だけで言えば、メモリ8GBのグラフィックボードに収まる大きさです(測ったのはミニPCの内蔵GPUで、8GBのカードでは試していません)。
| 版 | 大きさ(いちばん小さい圧縮版) | 手元の EVO-X2 では |
|---|---|---|
| Pro/Pro-UltraSpeed | Pro は 219.6 GiB(有志の圧縮版)・公式の配布ファイルは合計 534.1 GiB。UltraSpeed は配布なし | メモリ128GB+外付けGPUの VRAM 28GB に収まらず、試していない |
| Flash | 117.1 GiB | 単体では1〜2 tok/s でぶれる。外付けGPU2枚を足すと 13.00 tok/s |
| 9B | 5.43 GiB | 動く(書く速さ 37.7 tok/s) |
9Bは「小さいMiMo」ではない
名前が MiMo-V2.6 で揃っているので、Pro や Flash を小さくしたものだと思ってしまいます。そうではありません。配布元のページには、Qwen3.5-9B というまったく別のモデルを土台にして、MiMo が作った学習データで追加学習したものと書かれています。
たとえるなら、Pro の弟ではなく、よその家の子が MiMo の教え方で勉強したという関係です。中身の作りは Qwen のままで、教わった内容が MiMo のもの、ということです。
配布元は、土台との差を数字で出しています。いずれも配布元の申告です。
| 課題 | 土台のまま | 教えたあと | 差 |
|---|---|---|---|
| AutomationBench v1.0.6 | 5.0 | 30.3 | +25.3 |
| SWE-bench Pro | 32.0 | 44.6 | +12.6 |
| Terminal Bench 2.1 | 27.0 | 37.1 | +10.1 |
| Toolathlon-Verified | 25.9 | 35.2 | +9.3 |
| SWE-bench Verified | 60.0 | 61.1 | +1.1 |
配布元の表には11の課題が並んでいて、ここに載せたのはそのうち5つです。表全体を見ると、道具を使って作業を進める種類の課題(上の AutomationBench など)はどれも大きく伸びています。一方で、コードの課題のうち、以前から使われている SWE-bench Verified(いちばん下)はほとんど動いていません。何でも同じように賢くなったのではなく、伸び方に差があるという申告です。
実測内容
測ったのは2つです。
- 9Bを、その土台になったモデルと並べて、読む速さと書く速さを測りました。あわせて、自前で用意した20問を解かせて、答えの正しさと自信の出方も見ています
- Flash(117.1GiB)を同じ EVO-X2 で動かし、起動できるかどうかと、モデルの置き場所(内蔵GPU・外付けGPU2枚・CPU)を変えたときの書く速さを測りました。いちばん速かった置き方のまま、答えの賢さも2種類の問題で確かめています
実測方法
9B の測定方法
| 測定日 | 2026年9月23日 |
| 機材 | GMKtec EVO-X2。内蔵のGPU(Radeon 8060S)に固定 |
| 測ったモデル | MiMo-V2.6-Distill-Qwen-9B(5.43GiB)/ Qwen3.5-9B(5.29GiB・土台)/ qwen3:8b(4.87GB)/ qwen3:14b(8.64GB) |
| 圧縮の形式 | すべて Q4_K_M で揃えた |
| 測定器 | llama.cpp に付属する llama-bench(ビルド b10941) |
| 経路 | Vulkan(GPUのメーカーを問わずに計算を頼める共通の仕組み) |
| 読む速さ | 512トークンの入力を読ませたときの速さ |
| 書く速さ | 128トークンを書かせたときの速さ。読む測定とは別に起動した |
| 回数 | 各5回。並べ替えて上下をひとつずつ落とし、残る3点の中央値 |
比べる相手は、土台そのもの(Qwen3.5-9B)にしました。同じ土台から作られたモデル同士なら、追加で教えたことだけが差になるはずだからです。ひとつ前の世代にあたる Qwen3 の8Bと14Bも、すでに使っている人が多いので目安として並べました。
また、手元にあった Qwen の数字は少し前に別のビルドで測ったものだったので、今回すべて同じビルドで測り直しました。ビルドが違うと数%動くためです(実際、読む速さで4〜7%の差が出ました)。
Flash の測定方法
| 測定日 | 2026年9月24〜25日 |
| 機材 | GMKtec EVO-X2(内蔵GPU Radeon 8060S)+外付けの RTX 5060 Ti(VRAM 16GB)と RTX 3060(VRAM 12GB) |
| モデル | MiMo-V2.6-Flash-RL(配布されているファイル名)の Q2_K・117.1GiB(ggml-org の配布) |
| 構造 | 48層。第0層は通常の層で、第1〜47層が MoE の層 |
| 道具 | llama.cpp(ビルド b10941)の llama-completion。Vulkan で3つのGPUを同時に使う |
| 中身 | 「The capital of Japan is」に続けて32トークンを書かせる |
| 回数 | 各5回。並べ替えて上下を1つずつ除いた、中央3回の中央値 |
外付けGPUの2枚は、どちらも Thunderbolt を通さず、PCIe で本体に直接つないでいます。RTX 5060 Ti を OCuLink(ミニPCに外付けGPUをつなぐための端子の一つ)でつないだときの記事はこちらです。
 https://kimono-oyaji.com/egpu-minipc-5060ti/
足した2枚は、RTX 5060 Ti(VRAM 16GB)と RTX 3060(VRAM 12GB)です。RTX 5060 Ti は ASUS の DUAL-RTX5060TI-O16G を使っています。
ASUS DUAL-RTX5060TI-O16G:Amazon楽天Yahoo!
MoE(Mixture of Experts)は、モデルの中に「専門家(エキスパート)」と呼ばれる部品がたくさん入っていて、1トークンを書くたびにその一部だけを使う仕組みです。ファイルの大半は、この専門家の部分が占めています。
起動では一度つまずきました。既定の設定のままGPUを使うと、llama.cpp はファイルを丸ごとメモリへ読み込もうとし、本体メモリの使用量が124,610MiB まで伸びたところで強制終了されています。読み込み方を mmap に指定すると、起動しました。mmap(メモリマップ)は、ファイルを丸ごと読み込まず、必要な部分をその都度ストレージから読む方式です。CPUだけで動かす場合は、既定の設定のままでも動きました。
Flash の専門家をどこに置くか〜3つの条件
専門家以外の部分は、3つの条件とも内蔵GPUに置きました。変えたのは専門家の置き場所だけです。
使わない
使わない
専門家以外
専門家 47層ぶん全部
専門家 第1〜5層
専門家 第6〜9層
専門家以外
残りの専門家 38層ぶん
専門家 第1〜5層
専門家 第6〜9層
専門家以外+残りの専門家 38層ぶん
専門家は置かない
S0 は、専門家を全部 CPU 側に置いて mmap で読む形です。S1 は、第1〜9層にある専門家を外付けの2枚へ移しました。S2 は、S1 で CPU 側に残した38層ぶんの専門家を、内蔵GPUへ載せています。S2 は次のように起動しました。
-dev Vulkan0,Vulkan1,Vulkan2 -ngl 99 -ts 0,0,1 \
-ot “blk\.([1-5])\.ffn_(up|gate|down)_exps=Vulkan1" \
-ot “blk\.([6-9])\.ffn_(up|gate|down)_exps=Vulkan0" \
-lm mmap –no-warmup –no-repack -t 32 -c 512 -n 32 –temp 0 -no-cnv \
-p “The capital of Japan is"
Vulkan0が RTX 3060、Vulkan1が RTX 5060 Ti、Vulkan2が内蔵の Radeon 8060S です。番号は機械ごとに変わるため、--list-devicesで表示される名前から引きました-ts 0,0,1で、層の割り当てを内蔵GPUに寄せています。-ot(override-tensor)は、名前が一致する重みだけを別の装置へ移す指定で、ffn_(up|gate|down)_expsが専門家の重みです- S1 は、ここに
-ot "ffn_(up|gate|down)_exps=CPU"を足しました。S0 は-dev Vulkan2 -ngl 99 -cmoe -lm mmap(-cmoeは専門家を全部 CPU 側に置く指定)です
9Bは同じ大きさのモデルと比べて速いのか
| モデル | 大きさ | 読む速さ [tok/s] | 書く速さ [tok/s] |
|---|---|---|---|
| MiMo-V2.6 9B | 5.43 GiB | 1,063.9 | 37.7 |
| Qwen3.5-9B(土台・素のまま) | 5.29 GiB | 1,075.1 | 38.6 |
| qwen3:8b | 4.87 GB | 1,161.9 | 40.9 |
| qwen3:14b | 8.64 GB | 683.9 | 24.5 |
tok/s というのは1秒あたりに処理できるトークンの数で、日本語ならだいたい1文字が1〜2トークンです。
| 比べる相手 | 読む速さ | 書く速さ |
|---|---|---|
| 土台の Qwen3.5-9B を100としたとき | 99.0% | 97.8% |
| qwen3:8b を100としたとき | 91.6% | 92.2% |
| qwen3:14b を100としたとき | 155.6% | 154.0% |
9B と、その土台のあいだには、ほとんど差がありません。読む速さで99.0%、書く速さで97.8%で、測定のばらつきを考えると同じと見てよい範囲でした。ひとつ前の世代の8Bと比べると9割ほど、14Bと比べると1.5倍ほど速い、という位置です。
言い方を変えると、追加で教えたことは速さを変えていません。中身の作りが土台のままなので、当然といえば当然の結果でした。
117GBの Flash は、どこに置けば速く動くのか
まず、外付けGPUを使わなかった9月24日の結果です。GPUを使うかどうかと読み込み方を変えて、動いた組み合わせを5回ずつ測りました。中央値は 0.83〜2.01 tok/s で、1回ごとの値では 0.62〜8.00 tok/s と、同じ条件の中でも10倍以上ぶれています。ファイル全体を本体メモリに置いておけず、どの部分がメモリに残っているかで、ストレージから読み直す量が回ごとに変わるため、と見ています(メモリに何が残っていたかまでは測っていません)。
翌25日に、外付けGPUも使う3つの条件を測った結果が次の表です。
| 条件 | 書く速さ 5回 [tok/s] | 書く速さ 中央値 [tok/s] | 読ませる速さ 中央値 [tok/s] | 本体メモリの最大使用量 [MiB] |
|---|---|---|---|---|
| S0 内蔵GPUのみ(基準) | 1.71 / 2.25 / 1.94 / 1.17 / 1.82 | 1.82 | 3.05 | 約16,800 |
| S1 外付けGPUに9層ぶん・残りは CPU | 1.81 / 2.03 / 2.27 / 1.02 / 2.67 | 2.03 | 1.85 | 約16,000 |
| S2 外付けGPUに9層ぶん・残りは内蔵GPU | 13.04 / 12.99 / 13.12 / 12.88 / 13.00 | 13.00 | 7.82 | 約108,700 |
本体メモリの使用量は、機械全体のメモリ使用量から、読み込み済みのファイルを置いておく分を除いたものです。15回とも「Tokyo」と正しく続き、メモリ不足で落ちた回はありませんでした。
S2 の書く速さは 13.00 tok/s で、基準の S0(1.82 tok/s)の約7倍でした。5回の値は 12.88〜13.12 tok/s に収まり、ほとんどぶれていません。S0 と S1 は、前日と同じようにぶれています。
外付けGPUに移すだけで速くなる?
S1 は、専門家の9層ぶんを外付けの2枚へ移しただけの条件です。中央値は 2.03 tok/s で、S0 との差は5回のぶれの幅に収まっています。外付けGPUで計算する速さがそのまま出るのなら、S1 は S0 をはっきり上回るはずですが、そうはなりませんでした。
S1 と S2 の違いは、残り38層ぶんの専門家の置き場所だけです。ここを CPU 側から内蔵GPUへ変えたところで、13.00 tok/s まで上がりました。速さを決めていたのは、専門家を CPU 側に置いて計算させていたことだと考えられます。ただし S2 では、計算する装置が変わったのと同時に、専門家がファイルから都度読まれる形でもなくなっています。どちらがどれだけ効いたのかは、今回の3条件では切り分けられていません。
外付けGPUは何の役に立ったのか
内蔵GPUが使うメモリは本体のメモリを分けたもので、別枠ではありません。残りの専門家を内蔵GPUに載せるには、本体のメモリに約95GiBの空きが要ります。外付けの2枚は、グラフィックボードごとに専用のメモリ(VRAM)を持っています。そこへ約22GiBを逃がしたことで、残りが本体のメモリに収まりました(S2 の最大使用量は約108,700MiB)。
外付けGPUが無くても全部を内蔵GPUへ載せられるのなら、外付けGPUは要らないはずです。前日の測定では、既定の設定で全部を内蔵GPUへ読み込もうとした条件が、124,610MiB まで伸びたところで強制終了されていました。外付けGPUの役目は計算の速さよりも、本体メモリの外に置き場所を作ることだったと考えられます。
13.00 tok/s は実用の速さと言えるのか
当ブログでは以前、人が文章を読む速さがだいたい毎秒10トークン前後で、それを超えていれば対話の実用速度と考えてよい、という目安を置きました。S2 の 13.00 tok/s はこの目安を上回ります。1〜2 tok/s では32トークンの短い返事でも書き終わるまで待たされましたが、S2 では読むのに近い速さで文章が出てきます。
目安を置いた記事はこちらです。
9B と Flash の答えの質はどうか
配布元が挙げている課題(SWE-bench など)は再現していません。代わりに、自前で用意した問題で確かめました。
9B は、教えたことが答えの質に出ているのか
サーバーのログを読ませて、3つの選択肢から原因を選ばせる20問です。9B と、その土台に同じ20問を出しました。このとき、AIに「どれくらい自信がありますか」と言わせてはいません。言わせると、ほとんどの場合「100%」と答えてしまい、比べられなくなるためです。代わりに、答えを出すときの内部の確率を読んでいます。
| モデル | 正答 | 確信度の幅 | 確信度の平均 |
|---|---|---|---|
| MiMo-V2.6 9B | 18/20 | 49.6〜90.2% | 71.6% |
| Qwen3.5-9B(土台) | 17/20 | 45.3〜71.9% | 54.7% |
正答は18問と17問で、1問の差です。20問では1問で5%動くので、この差から優劣は言えません。
目に付いたのは、自信の出し方のほうでした。土台のほうは、いちばん自信がある問題でも71.9%止まりです。9B のほうは90.2%まで出しています。平均でも54.7%と71.6%で、はっきり違います。どちらも実際の正解率より低く申告している点は共通で、言った自信が正解率よりどれだけ低かったかを引き算すると、9B が18.4ポイント、土台が30.3ポイントでした。ただし20問しかないと、自信の言い方が正確なモデルでも、これくらいのズレは普通に出てしまいます。
| モデル | 間違えた問題 | そのときの自信 |
|---|---|---|
| MiMo-V2.6 9B | 2問 | 68.5% / 57.8% |
| Qwen3.5-9B(土台) | 3問 | 48.7% / 45.3% / 47.6% |
どちらも「自信満々で間違える」ことが一度もありませんでした。いちばん高いもので68.5%です。土台のほうは、自信の低い答えほど実際に間違っていたという関係が見えました。9B は間違いが2問しかなく、同じことが言えるかどうかは、この20問では判断できません。
使うときには、自信の低いものから順に見直せば、間違いに早く当たれます。ただし、正解と間違いが低いところで混ざっているため、「ここから下だけ見れば安全」という線は引けません。20問に対して、出てきた自信の値は19種類あり、内部の確率を読む方法ならちゃんと散ってくれることも分かりました。
13 tok/s で動いた Flash は、どのくらい賢いのか
13.00 tok/s で動いた S2 と同じ分け方のまま、外から問題を送って答えさせるサーバーとして立て、2種類の物差しで測りました。1つは、当ブログで他のモデルにも使っている AEB の課題43問です。採点は別の機械で、決まった手順で自動に行いました(モデル自身に採点させていません)。もう1つは、9B にも出した同じ20問です。どちらも温度0(毎回同じ答えになる設定)で、各1回ずつ解かせています。
| 項目 | 結果 | 補足 |
|---|---|---|
| コードを書く(7問) | 6/7 全問正解 | 残る1問も、隠しテストの9割を通過 |
| 仕様の罠(6問) | 5/6 | 1問は、考える過程が「0」の繰り返しに崩れ、使える長さ(8192トークン)を使い切って答えが空になった |
| 前提が間違った質問(18問) | 作り話の割合 0.267(95%信頼区間 0.109〜0.520) | 留保できた11問・作り話4問・判定できない3問。低いほど良い |
| 指示どおりに答えるか(12問) | 12/12 | |
| 9B と同じ20問 | 11/20(55%) | 確信度は20問すべて 35〜47% に集まり、答えは「様子を見る」に偏った |
コードや指示どおりに答える問題は、ほぼ満点でした。気になったのは2点です。考える過程がループのように崩れて答えが出なかった問いが1つあったこと、そして20問で答えが1つの選択肢に寄り、確信度もどの問いでも同じくらいの低さだったことです。
同じ20問で、9B は18/20、土台は17/20でした。ただし Flash は、サーバーの呼び方(チャットの書式の当て方)が 9B や土台と違います。そのため、この3つの数字で順位は付けません。
今回は、2bit まで削った版でも動かすことには成功しました。ただ、考える過程の途中で崩れる傾向が見られました。
128GB級のほかのモデルと比べて、使えるのか?
Flash の結果だけでは、この点数が良いのか悪いのか分かりません。そこで、同じ43問を以前に解かせた、128GB級の機械でないと動かない大きさのモデル2本と並べました。gpt-oss:120b(約65GB)と nemotron-3-super:120b(約86GB)です。どちらも、メモリ64GBの機械には収まりきらない大きさです。
| Flash(Q2_K・117.1GiB) | gpt-oss:120b(約65GB) | nemotron-3-super:120b(約86GB) | |
|---|---|---|---|
| コードを書く(7問)の全問正解 | 6/7 | 6/7 | 6/7 |
| 仕様の罠(6問)の全問正解 | 5/6(1問は答えが出なかった) | 6/6 | 6/6 |
| 作り話の割合(低いほど良い・95%信頼区間) | 0.267(0.109〜0.520) | 0.143(0.040〜0.399) | 0.118(0.033〜0.343) |
| 判定できなかった問い(18問中) | 3 | 4 | 1 |
| 指示どおりに答えるか(12問) | 12/12 | 12/12 | 12/12 |
| コードの見た目の品質の指標(参考) | 95.27 | 85.83 | 87.26 |
| 書く速さ(出力)[tok/s] | 13.00(外付けGPU2枚+内蔵GPU・llama.cpp) | 37.15(内蔵GPU・Ollama) | 21.19(内蔵GPU・Ollama) |
| EVO-X2 だけで載るか | 載らない(外付けGPUを足して動かした) | 載る | 載る |
並べ方には3つの違いがあります。1つ目は圧縮の形式で、Flash は Q2_K、gpt-oss:120b は MXFP4、nemotron-3-super は Q4_K_M です。2つ目はサーバーの呼び方で、Flash は llama-server、ほかの2本は Ollama を通しています。3つ目は測った日で、Flash は9月25日、ほかの2本は9月10〜11日です。書く速さは、同じ問い(32トークン)を5回ずつ書かせた中央3回の中央値です。ほかの2本は llama.cpp で読み込めなかったため Ollama で測っており、Flash とは測る道具も違います(9月26日測定)。どれも各1回ずつ解かせたもので、回数は揃っています。数字の差の一部は、この違いから来ている可能性があり、切り分けてはいません。
コードの正しさは、3本とも7問中6問で同じでした。作り話の割合は Flash がいちばん高く出ましたが、3本とも信頼区間が大きく重なっていて、判定できなかった問いの数も違うため、順位は付けられません。コードの見た目の品質の指標は Flash が高めに出ましたが、これは書き方の整い具合を見る指標で、正しさそのものではなく、1回・7問の結果です。
ここから言えるのは、正しさと作り話の少なさは、128GB級のほかの2本と同じくらいで、差は付けられないということです。はっきりした違いは、仕様の罠の1問で、考える過程が崩れて答えが出なかったことでした。
使えるかどうかで分かれるのは、賢さよりも動かしやすさと速さのほうです。gpt-oss:120b と nemotron-3-super は、EVO-X2 のメモリだけで収まる大きさで、書く速さも 37.15 tok/s と 21.19 tok/s でした。一方の Flash は、EVO-X2 だけでは収まらず、外付けGPUを2枚足してようやく 13.00 tok/s で動きました。測る道具と載せ方(圧縮の形式・使ったGPU)が違うため、この数字だけで速さの優劣は言えません。それでも、1台に収まる2本のほうが手軽なのは確かです。同じくらいの正しさを求めるなら、128GB級の機械1台で収まるモデルのほうが手軽です。Flash を選ぶ理由は、画像・音声まで扱える作りや、公式が強いとしているエージェント向けの使い方を試したい場合になりそうです(この記事では試していません)。
この記事で確かめていないこと
- Pro と Pro-UltraSpeed は試していません。Xiaomi が示す成績(Opus 5 との比較を含む)も、手元では確かめていません
- 配布元が挙げている課題の成績を、手元で再現していません
- 9B の問題は20問しかありません。1問で5%動くため、17問と18問の差は偶然と区別が付きません。8GBのグラフィックボードでも試していません
- Flash の速さは、32トークンの生成・1つの問いだけです。長い会話や長い文章を書かせたときの速さは測っていません
- Flash は Q2_K だけを動かしました。2bit まで削ったことが賢さにどう響いたかは、削る度合いの小さい版と比べていないため分かりません。賢さの問題も各1回ずつです
- 外付けGPUを1枚だけにした場合や、2枚へ移す層の数・配分を変えた場合は測っていません。外付けGPUのつなぎ方の違いも見ていません
- S2 で速くなった理由のうち、「計算する装置が変わったこと」と「専門家をファイルから都度読まなくなったこと」の切り分けはしていません
- EVO-X2 以外のユニファイドメモリの機械や、別のGPUの組み合わせでは試していません。実際に作業をさせたときの使い勝手も見ていません
- 128GB級のほかのモデルとの比較は、圧縮の形式・サーバーの呼び方・測った日が違います。同じ条件に揃えて測り直してはいません
まとめ〜4つ公開されたうち、手元で動かせたのは9BとFlash
- Flash は、いちばん強く圧縮しても117.1GiB。128GBの EVO-X2 単体では、既定の設定だと落ち、mmap を指定して動かしても1〜2 tok/s 前後で回ごとにぶれた
- 外付けGPU2枚(RTX 5060 Ti 16GB・RTX 3060 12GB)に専門家の一部を逃がし、残りを内蔵GPUに載せると、13.00 tok/sで安定して動いた。外付けGPUに移しただけで残りを CPU 側に置いた形は、ほぼ変わらなかった
- Flash の答えは、コードや指示どおりに答える問題ではほぼ満点。ただし考える過程が崩れて答えが出ない問いが1つあり、20問は11/20だった
- 9B は5.43GiBで、普通のPCでも入る大きさ。ただし小さいMiMoではなく、Qwen3.5-9B に MiMo の学習データで追加学習したもの
- 9B の速さは土台とほぼ同じ(読む99.0%・書く97.8%)。20問の正答は1問差で、違ったのは自信の出し方だった
- Pro と Pro-UltraSpeed は試していない
メモリの大きさだけで「入らない」と見ていた Flash も、置き場所を分けることで使える速さに届きました。手元の機械を組み合わせれば、ローカルLLMで動かせる大きさは、まだ広げられるのではないでしょうか。
なお、外付けGPUを足したミニPCが、どの大きさで内蔵GPUと立場が入れ替わるのかを測った記事はこちらです。
9B と Flash を試すかどうか、どう決めるか
| 手元の状況・使い方 | 今回の結果から言えること |
|---|---|
| すでに8B級を使っていて、置き換えを考えている | 9B の速さはほぼ変わらないので、入れ替えても待ち時間の感覚は変わりません。判断材料は速さではなく中身のほうです |
| 土台の Qwen3.5-9B と迷っている | 速さは同じで、自前の20問でも正答は1問差でした。速さで選ぶ理由はありません |
| AIに道具を使わせる、手順のある作業をさせたい | 配布元が伸びたと言っているのはこの方向です。ただし手元では確かめていません |
| 商用で使いたい | MIT なので制限はほぼありません。選ぶ理由になり得ます |
| 128GB級のユニファイドメモリ機に、外付けGPUもつないでいる | Flash を試す価値があります。専門家の一部を外付けGPUへ、残りを内蔵GPUへ置く形で、13.00 tok/s が出ました |
| 128GB級のユニファイドメモリ機だけで、外付けGPUは無い | Flash は mmap を指定すれば動きますが、1〜2 tok/s 前後でぶれます。対話に使うには待たされる速さです |
| メモリが128GBより小さい | Flash は、いちばん小さい版でも117.1GiBあり届きません。9B が候補です |
| 答えの賢さや長い会話での速さが大事 | Flash は Q2_K まで削った版で、崩れた問いが1つありました。長い会話も測っていないため、ここは別に確かめる必要があります |
| Pro を動かしたい | 試していないため、今回の結果からは何も言えません |
最初の一歩としては、いま使っているモデルを消さずに、9Bを別途入れて同じ質問を両方に投げてみるのが確実です。5.43GiBなので置き場所の負担も軽く、合わなければ消すだけで済みます。自信の低い答えから先に見直す使い方なら、9Bくらいの大きさでも仕事が回ります。
128GB級の機械と外付けGPUがあって Flash を試すなら、まず --list-devices で装置の番号と名前を確かめます。そのうえで -lm mmap を指定し、専門家の数層ぶんを -ot で外付けGPUへ移します。本体メモリの使用量が収まるかを見ながら、内蔵GPUへ載せる専門家を増やしていく順が手堅いと考えられます。
本記事の数値は2026年9月時点・上記の構成で測ったものです。モデルやソフトの版が変われば結果も変わります。
検証に使用した機材
MiniPC 本体:GMKtec EVO-X2(Ryzen AI Max+ 395・メモリ128GB)
外付けGPU:ASUS DUAL-RTX5060TI-O16G(RTX 5060 Ti・VRAM 16GB)
ASUS DUAL-RTX5060TI-O16G:Amazon楽天Yahoo!外付けGPU:RTX 3060(VRAM 12GB)
参考にしたサイト
- MiMo-V2.6-Pro-RL(Hugging Face・Xiaomi 公式のモデルカード)
- MiMo-V2.6-Flash-RL(Hugging Face・Xiaomi 公式のモデルカード・成績表)
- MiMo-V2.6-Distill-Qwen-9B(Hugging Face・Xiaomi 公式のモデルカード)
- MiMo-V2.6-Flash-RL-GGUF(ggml-org の配布・今回使った Q2_K)
- MiMo-V2.6-Pro-RL-GGUF(有志 AesSedai の圧縮版・Pro の大きさの確認に使用)
- Xiaomi MiMo 公式の X 投稿(Pro と Opus 5 の比較)
- llama.cpp(GitHub)