Ollama のモデル一覧を開くと、名前が何百も並んでいます。どれを最初に入れればいいのでしょうか。当ブログでは、2026年にかけて 50本あまりのモデルを同じ機械で測ってきました。その数字を「自分のPCに載るか」「速いか」「賢いか」の3つで並べ直し、用途ごとに候補を絞ってみます。
2026年10月時点の内容です。
どう選ぶか〜3つの物差し
モデル選びで迷う理由は、物差しが混ざっているためだと考えています。この記事では次の3つに分けます。
| 物差し | 何を見るか | この記事の数字 |
|---|
| 載るか | モデルのファイルサイズが、GPUのメモリ(VRAM)か、ミニPCの共有メモリに収まるか | Q4_K_M 形式(4ビット量子化=精度を少し落として容量を約4分の1にした形式)のファイルサイズ [GiB] |
| 速いか | 1秒に何トークン(おおむね日本語で1〜2文字)書けるか | 書く速さ tg128 [tok/s]・読ませる速さ pp512 [tok/s] |
| 賢いか | 短いプログラムを正しく書けるか、ひっかけ問題に引っかからないか | AEB L1(コーディング7問・ひっかけ6問・偽前提の作話率) |
「賢さ」は当ブログ独自の短い試験で、日本語の上手さや文章の好みは測っていません。この点は後ろの「確かめていないこと」にまとめます。
当ブログには、近い題材の記事がいくつかあります。10月2日の「スマホやアプリで動かすならどれ?」は 4B 以下の23本を賢さ・速さ・サイズで比べたもの、9月の「VRAM8GBで何が動く?」は22本を必要メモリ別に並べたもの、6月の「Gemma 4 と Qwen 3.6、どっち?」は2つの家族を VRAM 別に比べたもの、「モデルの選び方 5つの軸」は選ぶときの考え方です。この記事はそれらをつなぐ入口で、用途ごとに「最初の1本」を決めるところまでを担当します。小型23本の表は10月2日の記事にあるので、ここでは上位だけを引き、中型以上は10月3日に測った新しい数字を載せました。
用語を短く添えます。Q4_K_M は「4ビット量子化」で、精度を少し落として容量を約4分の1にした形式です。tg128 は128トークンを書かせたときの速さ、pp512 は512トークンを読ませたときの速さです。トークンは日本語でおおむね1〜2文字にあたります(目安で、文章により変わります)。MoE は「複数の専門家を内蔵し、問いごとに一部だけを使う仕組み」で、ファイルは大きくても一度に働く部分が小さいため速く動きます。作話率は、偽の前提を含む18問に対して、誤りを指摘せずに作り話で答えた割合です。
速さと賢さをどう測ったか
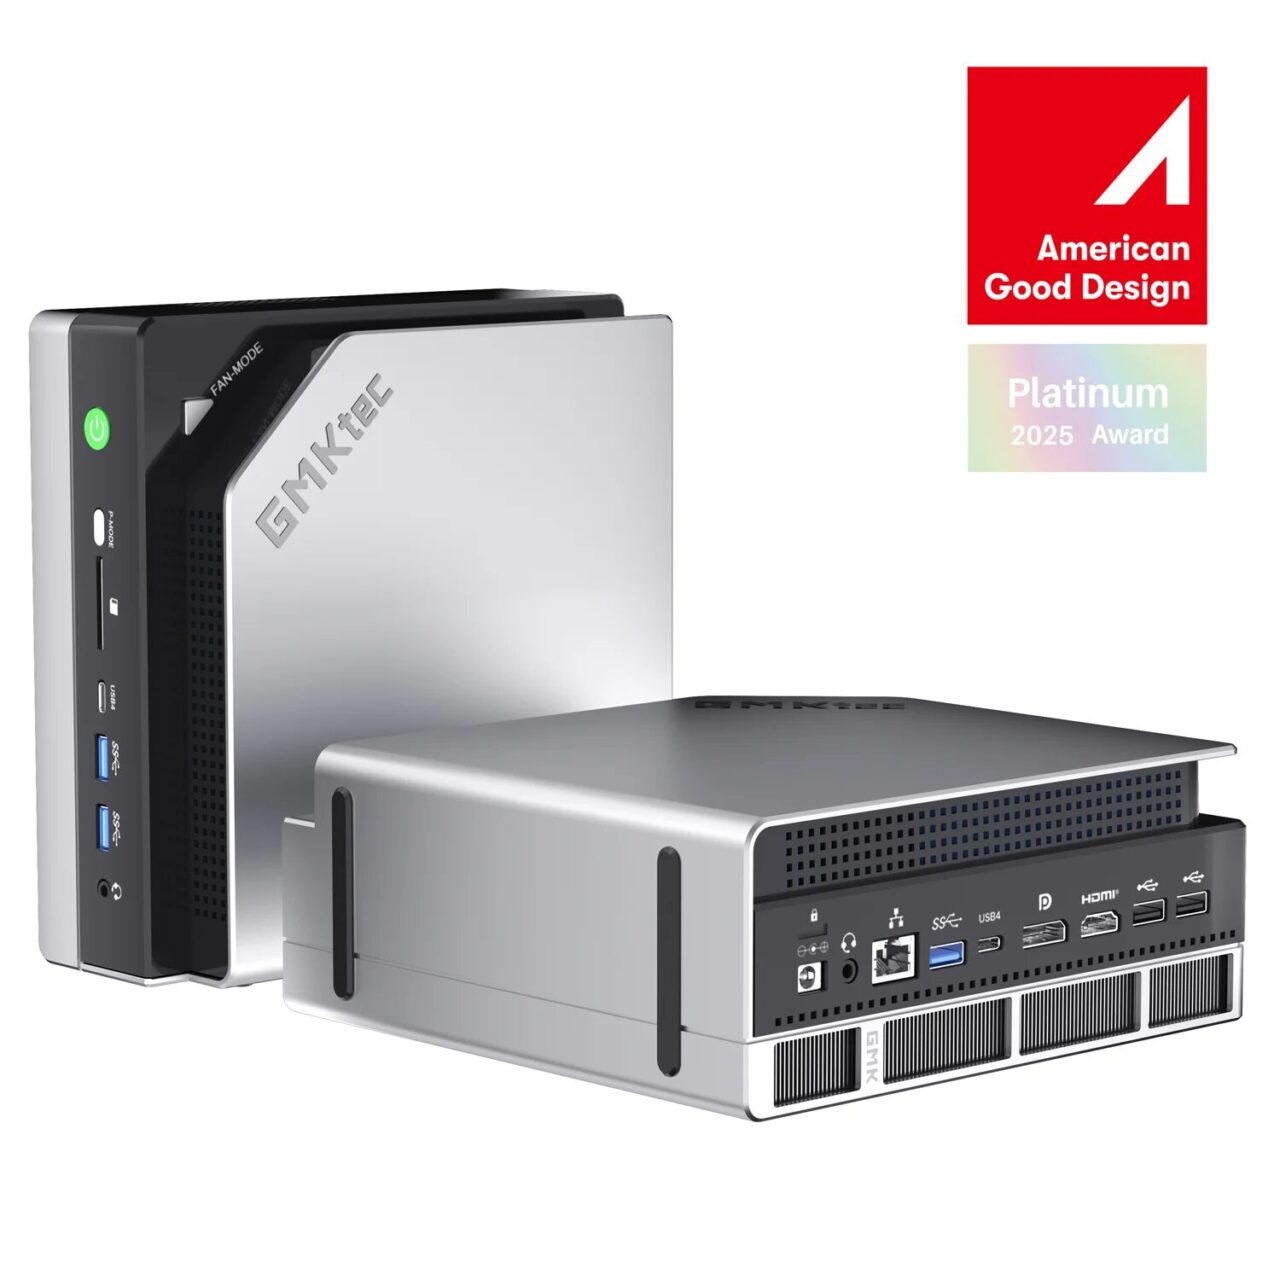
速さは GMKtec EVO-X2(Ryzen AI Max+ 395・メモリ128GB)の内蔵GPU Radeon 8060S で測りました。llama.cpp の公式ビルド b11192 を使い、同じ条件で5回測って上下を1つずつ落とし、中央3点の中央値を採っています。小型モデル23本は 2026年9月29日、中型(9〜35B)は10月3日の測定です。大型(100B 級)は10月3日の追加測定を含みますが、一部は9月の Ollama や古いビルド(b10605)の値で、表の備考に書きました。中型の賢さは10月3日に小型と同じ版で測りました。
賢さは、同じ問いを各モデルに1回ずつ投げて採点しています(RTX 3090・Ollama・temperature 0)。小型23本は「7問中いくつ正解したか」、大型8本は「100点満点の平均点」で記録しており、採点の版が違うため、小型と大型の点は並べて比べません。
まず1本入れるなら〜VRAM 8GB以下で速くて賢い
ゲーミングノートや 8GB のグラフィックボードなら、ファイルが 3GB 前後のモデルから試すのを勧めます。小型23本の全体は10月2日の記事に表があるので、ここでは上位の4本だけを引きます。コーディング7問とひっかけ6問を両方とも全問正解したのは、このうち上の2本でした。
| モデル(Ollama での名前) | サイズ [GiB] | コーディング | ひっかけ | 書く速さ [tok/s] | 読ませる速さ [tok/s] |
|---|
| Qwen3.5-4B(hf.co/unsloth/Qwen3.5-4B-GGUF:Q4_K_M) | 2.54 | 7/7 | 6/6 | 65.4 | 1,987 |
| Nemotron 3 Nano 4B(nemotron-3-nano:4b) | 2.63 | 7/7 | 6/6 | 69.5 | 1,940 |
| MiniCPM5-2B(hf.co/bartowski/MiniCPM5-2B-GGUF:Q4_K_M) | 1.50 | 6/7 | 6/6 | 123.8 | 3,826 |
| Gemma 4 E2B(hf.co/unsloth/gemma-4-E2B-it-GGUF:Q4_K_M) | 2.88 | 6/7 | 6/6 | 116.1 | 3,179 |
書く速さ 65 tok/s は、日本語なら1秒に 60〜100文字ほどで、読むより速く出てきます。最初の1本は Qwen3.5-4B を勧めます。偽前提の問いに作り話で答えてしまう率(作話率)が 0.07 と、賢さを測った23本の中でいちばん低かったためです。ただし18問の試験なので信頼区間は広く、順位は確定的ではありません。Nemotron 3 Nano 4B は同じ正解数ですが作話率が 0.45 で、偽の前提をそのまま受けて答えてしまう場面が目立ちました。
もっと軽くしたいなら MiniCPM5-2B です。1.5GB で 124 tok/s と倍の速さで、正解数は1問落ちるだけでした。
コーディングを手伝わせたい〜16〜24GBで本命を
プログラムを書かせる用途で候補になるモデルを、当ブログで測った賢さと、EVO-X2 の内蔵GPUでの速さとともに並べます。長い指示での崩れにくさは、この試験では測っていません。
| モデル(Ollama での名前) | サイズ [GiB] | コーディング平均点 | ひっかけ平均点 | 書く速さ [tok/s] | 載る目安 |
|---|
| Qwen3 Coder 30B(qwen3-coder:30b) | 17.3 | 95.0 | 6/6(正解数) | 91.1 | VRAM 24GB |
| Nemotron 3 Nano 30B(nemotron-3-nano:30b) | 22.6 | 96.7 | 6/6(正解数) | 69.0 | VRAM 24GB |
| Ornith 1.5 35B-A3B(hf.co/deepreinforce-ai/Ornith-1.5-35B-A3B-GGUF:Q4_K_M) | 20.2 | 95.3 | 6/6(正解数) | 75.5 | VRAM 24GB |
| Ornith 1.5 9B(hf.co/deepreinforce-ai/Ornith-1.5-9B-GGUF:Q4_K_M) | 5.4 | 87.4 | 6/6(正解数) | 38.7 | VRAM 8GB |
| Qwen3-Coder-Next(qwen3-coder-next) | 48.2 | 95.2 | 96.4 | 未測定 | メモリ128GBのミニPC |
Qwen3 Coder 30B は、30B と名乗りながら一度に働く部分が小さい作り(MoE)のため、17GB のファイルで 91.1 tok/s と、4B の Qwen3.5-4B(65.4 tok/s)より速く動きました。短い会話の設定なら、VRAM 24GB の RTX 3090 に丸ごと載ります。16GB のグラフィックボードにはファイルが収まりません。コーディング7問は全問正解で、平均点 95.0 でした。
24GB の3本(Qwen3 Coder 30B・Nemotron 3 Nano 30B・Ornith 1.5 35B-A3B)は、コーディングもひっかけも全問正解で、平均点は 95〜97 に並びました。この試験では差が付かない水準(天井)に達しており、3本の間に順位は付けられません。速さで選ぶなら Qwen3 Coder 30B の 91 tok/s です。
8GB に収めたいなら Ornith 1.5 9B です。5.4GB でコーディング 6/7・ひっかけ 6/6、平均点は 87.4 でした。書く速さ 39 tok/s は 4B 級の 6割ほどです。
できるだけ賢く〜24GBに載る上限
VRAM 24GB に収まる範囲で、賢さを測った3本を並べます。
| モデル(Ollama での名前) | サイズ [GiB] | コーディング平均点 | ひっかけ平均点 | 作話率 | 書く速さ [tok/s] |
|---|
| Gemma 4 31B(hf.co/unsloth/gemma-4-31B-it-GGUF:Q4_K_M) | 17.1 | 95.9 | 97.2 | 0.15 | 11.6 |
| Qwen3.6 27B(hf.co/unsloth/Qwen3.6-27B-GGUF:Q4_K_M) | 15.7 | 95.1 | 94.8 | 0.13 | 12.6 |
| Qwen3.6 35B-A3B(hf.co/unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M) | 20.6 | 94.7 | 94.8 | 0.21 | 62.7 |
3本とも平均点は 95 前後で並び、点差で順位を付けられるほどの差はありませんでした。使い分けは速さで決めるのがよさそうです。Gemma 4 31B と Qwen3.6 27B は EVO-X2 の内蔵GPUで 12 tok/s 前後、Qwen3.6 35B-A3B は 63 tok/s と5倍の差がありました。35B-A3B は MoE(複数の専門家を内蔵し、問いごとに一部だけを使う仕組み)で、一度に働く部分が 3B 分だけのためです。日本語の品質は当ブログでは測っていません。
メモリ128GBのミニPCなら〜100B級が動く
EVO-X2 のように共有メモリが 128GB あるミニPCでは、60GB を超えるモデルも読み込めます。内蔵GPUでの書く速さは次のとおりです。測った時期とソフトが行ごとに違うので、備考を添えました。
| モデル(Ollama での名前) | サイズ [GiB] | コーディング平均点 | 書く速さ [tok/s] | 備考 |
|---|
| gpt-oss 120B(hf.co/ggml-org/gpt-oss-120b-GGUF) | 59.0 | 85.8 | 55.2 | MXFP4 形式。llama.cpp b11192(Ollama では 37.2 tok/s・2026年9月) |
| Nemotron 3 Super 120B-A12B(nemotron-3-super:120b-a12b) | 80.0 | 87.3 | 21.2 | Ollama で5回測定(2026年9月) |
| GLM-4.5-Air(Q4_K_M) | 67.8 | 未測定 | 25.6 | llama.cpp b10605 |
| Qwen3 235B(Q2_K) | 79.8 | 未測定 | 21.8 | 2ビット量子化。llama.cpp b10605 |
| MiniMax M2.7(minimax-m2.7) | 101.0 | 未測定 | 29.1 | llama.cpp b10605 |
100B 級でも 21〜55 tok/s と、人が読む速さは十分に超えています。賢さの平均点は gpt-oss 120B・Nemotron 3 Super とも 85〜87 で、24GB に載る 27〜31B の3本(95 前後)とは数字の上で差がありますが、各モデル1回の測定で、9B 以上は天井に近い試験のため、この差から優劣は付けていません。この試験はコーディングとひっかけの短い問いなので、長い文書の要約や知識量では違う見え方になる可能性があります。
小さく速く〜1B 前後は何ができるか
スマホや古いノートPCを想定した 1B 以下は、23本の中で最下段でした。Qwen3-0.6B は 356 tok/s と最速でしたが、コーディングは 7問中1問にとどまり、Llama 3.2 1B・gemma-3-1b・MiniCPM5-1B も同じ帯です。詳しい表と読み方は10月2日の記事に譲ります。日本語向けに追加学習された Qwen3.5-0.8B-Japanese-SFT も測りましたが、コーディングとひっかけは 0問でした。作者が公表している日本語の常識問題の成績とは測っているものが違うため、この結果は日本語の出来を示すものではありません。
確かめていないこと
・日本語の文章の品質は測っていません。賢さはコーディング7問・ひっかけ6問・偽前提18問の結果です
・賢さは各モデル1回の測定で、小型と大型で採点の版が違います。9B 以上はコーディング7問・ひっかけ6問がほぼ満点に達しており(天井)、この試験では上位どうしの順位は付けられません。小型(7問中の正解数)と大型(100点満点の平均)は並べて比べていません。作話率は18問の結果で信頼区間が広く、順位を付ける根拠にはしていません
・「載る」は短い会話の設定での目安です。長い文脈を扱うと、会話の記憶(KVキャッシュ)の分だけメモリが余計に要ります
・速さは EVO-X2 の内蔵GPUでの値です。Gemma 4 31B・Qwen3.6 の2本・gpt-oss 120B は Ollama 配布版ではなく Hugging Face の公式 GGUF で測りました(Ollama 配布版は llama.cpp で読めない形式のため)。NVIDIA のグラフィックボードでは数字が変わります(RTX 3090 での値は別の記事にあります)
・大型の一部は llama.cpp の古いビルド(b10605)や Ollama での測定が混ざっています。表の備考に明記しました
・モデルの版は 2026年9〜10月時点のものです。Ollama のタグは更新されるため、同じ名前でも中身が変わることがあります
まとめ〜最初の1本と、次の1本
VRAM 8GB 以下なら Qwen3.5-4B。コーディングなら 24GB の Qwen3 Coder 30B か、8GB の Ornith 1.5 9B。できるだけ賢くなら Gemma 4 31B・Qwen3.6 27B・Qwen3.6 35B-A3B のどれか。メモリ128GB のミニPCなら gpt-oss 120B。測った結果からは、そう整理できます。
次の行動としては、まず自分の VRAM を確かめて、上の表から1本だけ入れてみることを勧めます。Ollama の入れ方と最初の会話までは、次の記事にまとめています。
載せたいモデルが決まっていて、機材のほうを選びたい場合は、GPU の一覧とローカルAIのまとめからどうぞ。
検証に使用した機材
速さの測定は GMKtec EVO-X2(Ryzen AI Max+ 395・メモリ128GB)、賢さの測定は RTX 3090 を載せたデスクトップで行いました。
GMKtec EVO-X2 (Ryzen AI Max+ 395 / 128GB / 2TB)A8限定クーポン「A82608」で5,000円OFF(2026/10/31まで)/公式オンラインストアのクーポン「KANSYA2026」で2,000円OFF(2026/10/18まで)
¥583,000
Amazon・2026-10-04調べ
公式サイトのみ ¥5,000引きクーポン配布中 クーポンコード A82608(2026-10-31まで)
【中古】MSI GeForce RTX 3090 GAMING X TRIO 24GB
¥148,000
Amazon・2026/5/1調べ

 https://kimono-oyaji.com/small-llm-size-smartness-speed-2026...