Qwen4 の先行版は家で動く?〜Qwen3.8-Flash-Next の2ビット版を RTX 5060 Ti と RTX 3060 で測った
X のタイムラインで「Qwen3.8-Flash-Next が家で動いた」という投稿を続けて見かけました。Qwen4 の設計を先に公開した 125B のモデルで、一度に働くのは 6B 分だけという作りです。ただ、普通の llama.cpp では「unknown architecture」で読み込めません。手元の RTX 5060 Ti(16GB)と RTX 3060(12GB)で、本当に動くのでしょうか。専用のエンジンを使って、2ビット版を測ってみました。
2026年10月時点の内容です。
GPU に載らない分(n-gram テーブルと専門家の大半)は、機体のメモリと SSD から読みます。GPU の VRAM は「専門家のキャッシュ」と KV キャッシュに使われます。5060 Ti では専門家キャッシュに約 9.3GB が割り当てられました。
5回とも成功し、中央3点の幅は 1〜2 tok/s でした。書く速さは、16GB の RTX 5060 Ti で 70 tok/s、12GB の RTX 3060 で 46 tok/s です。当ブログの実測で言うと、同じ EVO-X2 の内蔵GPUで Qwen3.6 27B(4ビット)を動かしたときの 12.6 tok/s より速く、Qwen3 Coder 30B(91 tok/s)には届かない、という位置です。125B と名乗るモデルが、12GB のグラフィックボードで人が読むより速く書く、というのは意外な結果でした。
長い入力(約5,600トークン)を読ませる時間は、5060 Ti で 4.4 秒、3060 で 6.2 秒です。2枚を束ねると書く速さは変わらないのに、読む時間が 19.4 秒と、5060 Ti 単独の 4.4倍(3060 単独の 3.1倍)かかりました。原因は確かめていません。このモデルと Strata のレイヤー分割という今回の条件では、束ねる利点はありませんでした。

目次
Qwen3.8-Flash-Next とは何か〜Qwen4 の先行版
Qwen3.8-Flash-Next は、Alibaba の Qwen チームが 2026年8月下旬に重みを公開したモデルです(Hugging Face: Qwen/Qwen3.8-Flash-Next)。Qwen4 の新しい設計(Gated DeltaNet・Qwen Sparse Attention・n-gram 埋め込み)を先行して試せる位置づけです。125B のうち、1トークンあたり 6B 分だけが働く MoE(複数の専門家を内蔵し、問いごとに一部だけを使う仕組み)です。配布元の説明では、ファイルに 51B 分の n-gram 埋め込みテーブルと、投機的デコード(先読みで複数トークンをまとめて出す仕組み)用の 4B の MTP ヘッドが含まれます。Hugging Face では unsloth・bartowski・ISTA-DASLab などが GGUF(llama.cpp 系で読む形式)を出しています。 難しいのは動かす側です。llama.cpp 本流では 2026年10月3日時点で対応が取り込まれておらず、対応の PR(ggml-org/llama.cpp #27742)から自分でビルドする必要があります。当方はビルドをしていません。代わりに、ISTA-DASLab が配布する GSQ-RCO 形式の GGUF(Hugging Face: ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF)と、それを読める専用エンジン Strata(GitHub: Niko1221/Strata・バージョン 0.1.31)を使いました。スポンサーリンク
何を測ったか〜12GB と 16GB のグラフィックボードで
| 項目 | 内容 |
|---|---|
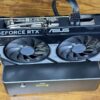
| 機体 | GMKtec EVO-X2(Ryzen AI Max+ 395・メモリ128GB・Ubuntu 26.04)。OCuLink で RTX 5060 Ti 16GB と RTX 3060 12GB を外付け |
| モデル | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF の Q2_0(2ビット)・約66GB(本体 35.0GB+n-gram テーブル 26.8GB) |
| エンジン | Strata 0.1.31(CUDA 13.0・KV キャッシュ=会話の記憶を int8 で保持・投機的デコードの設定値 4・MTP あり・最大文脈 32,768トークン) |
| 測り方 | 短い会話(入力 約73トークン)と、長い入力(約5,585トークン)の2種類を、各5回。並べ替えて上下を1つずつ落とし、中央3点の中央値 |
| 測った日 | 2026年10月2日 |
結果〜書く速さは 5060 Ti で 71 tok/s、3060 で 46 tok/s
| 構成 | 書く速さ・短い会話 [tok/s] | 書く速さ・長い入力 [tok/s] | 最初の1トークンまで・短い会話 [秒] | 最初の1トークンまで・長い入力 [秒] |
|---|---|---|---|---|
| RTX 5060 Ti 16GB 単独 | 70.7 | 70.7 | 1.04 | 4.42 |
| RTX 3060 12GB 単独 | 45.6 | 47.0 | 1.57 | 6.19 |
| 両方(レイヤー分割) | 70.1 | 73.5 | 1.05 | 19.44 |
スポンサーリンク
なぜ 12GB で動くのか〜載せているのは一部だけ
ファイルは 66GB あるのに 12GB の GPU で動くのは、一度に使う専門家(6B 分)だけを GPU の VRAM に置き、残りを機体のメモリに置いて必要なときに読む作りのためです。EVO-X2 のメモリは 128GB なので、66GB のファイルを丸ごとメモリに置けます。メモリが 64GB の機体でも、n-gram テーブルを SSD に置く設定で動くと Strata の配布元は説明しています。試していませんが、第三者(Strata 開発者の記録)が RAM 64GB の機体で動かした測定は、次の節で紹介します。賢さは測っていない〜2ビットの代償は未確認
今回測ったのは速さだけです。2ビット量子化は精度の低下が大きい形式で、同じモデルの 4ビット版や、Qwen3.8-27B と比べてどれだけ賢さが落ちるかは確かめていません。当ブログの賢さの試験(コーディング7問・ひっかけ6問)は Ollama 経由で行っており、Strata には繋いでいません。賢さの測定は次の記事に回します。スポンサーリンク
第三者の測定〜RTX 5070 12GB・メモリ 64GB の記録
Strata 開発者の公開記録(2026年9月29日付・Strata 0.1.26・同じ Qwen3.8-Flash-Next の 2ビット版)に、RTX 5070(12GB)・Ryzen 5 7600・メモリ 64GB(DDR5-5200)・Windows 10 の機体の測定があります。当ブログの測定ではなく、各条件1回の記録です。64GB は測定した機体の構成で、必要な最小量を示すものではありません。 項目:値 ・書く速さ(入力 4K 区分):93.0 tok/s ・書く速さ(入力 32K 区分):81.8 tok/s ・書く速さ(入力 128K 区分):73.7 tok/s ・読む速さ(入力 32K 区分):2,171 tok/s ・長いログ(31,566トークン)を渡してから最初の1トークンが出るまで:16.02 秒 当方の 5060 Ti(70.7 tok/s)と数字が違うのは自然ですが、版(0.1.26 と 0.1.31)・機体・入力長・出力長が揃っていないため、並べて GPU の優劣や順位は付けません。分かるのは、メモリ 64GB・VRAM 12GB の構成でも同じモデルが動いた記録がある、ということです。読む速さが毎秒 2,000 トークンを超えても、長い資料は最初の1トークンまでに十数秒かかります。 出典:github.com/Niko1221/Strata の bench/results/2026-09-29-speed-0126(確認 2026年10月4日)。確かめていないこと
・賢さ(2ビット化でどれだけ落ちるか) ・llama.cpp 本流で動く版(PR #27742 のビルド)との速さの違い ・メモリ 64GB の機体での追試(第三者の記録はあるが、未追試) ・2枚を束ねたときに長い入力の読み込みが遅くなった原因 ・EVO-X2 の内蔵GPU(Radeon 8060S)だけで動かした場合(Strata は CUDA 用で、試していません)スポンサーリンク
まとめ〜Qwen4 の先行版は、16GB のグラボで「速く書く」ところまでは来た
Qwen3.8-Flash-Next の 2ビット版は、RTX 5060 Ti で 70 tok/s、RTX 3060 で 46 tok/s で書きました。llama.cpp 本流ではまだ読めないため、専用エンジンか対応ブランチが要ります。賢さは未測定で、2ビットの代償がどれほどかは次の記事で確かめます。 次の行動としては、メモリ 128GB の機体を持っている人は 2ビット版から試す、持っていない人は 4ビットの Qwen3.8-27B(当ブログで実測済み)から入る、という分け方を勧めます。
 https://kimono-oyaji.com/new-llm-models-classified-202609/
検証に使用した機材


スポンサーリンク