Ollama で入れたモデルは、1つの大きなファイル(blob)として保存されています。中身は GGUF なので、llama.cpp の llama-bench でそのまま読めるはずでした。ところが、9月に測ろうとした6本と、10月に加えた1本の計7本が「failed to load model」で止まります。空き容量は十分で、ファイルも壊れていません。何が違うのでしょうか。10月3日に原因を確かめ、別の入れ物で同じモデルを測り直しました。
2026年10月時点の内容です。
どう測ったか〜Ollama の blob を llama-bench で直接読む
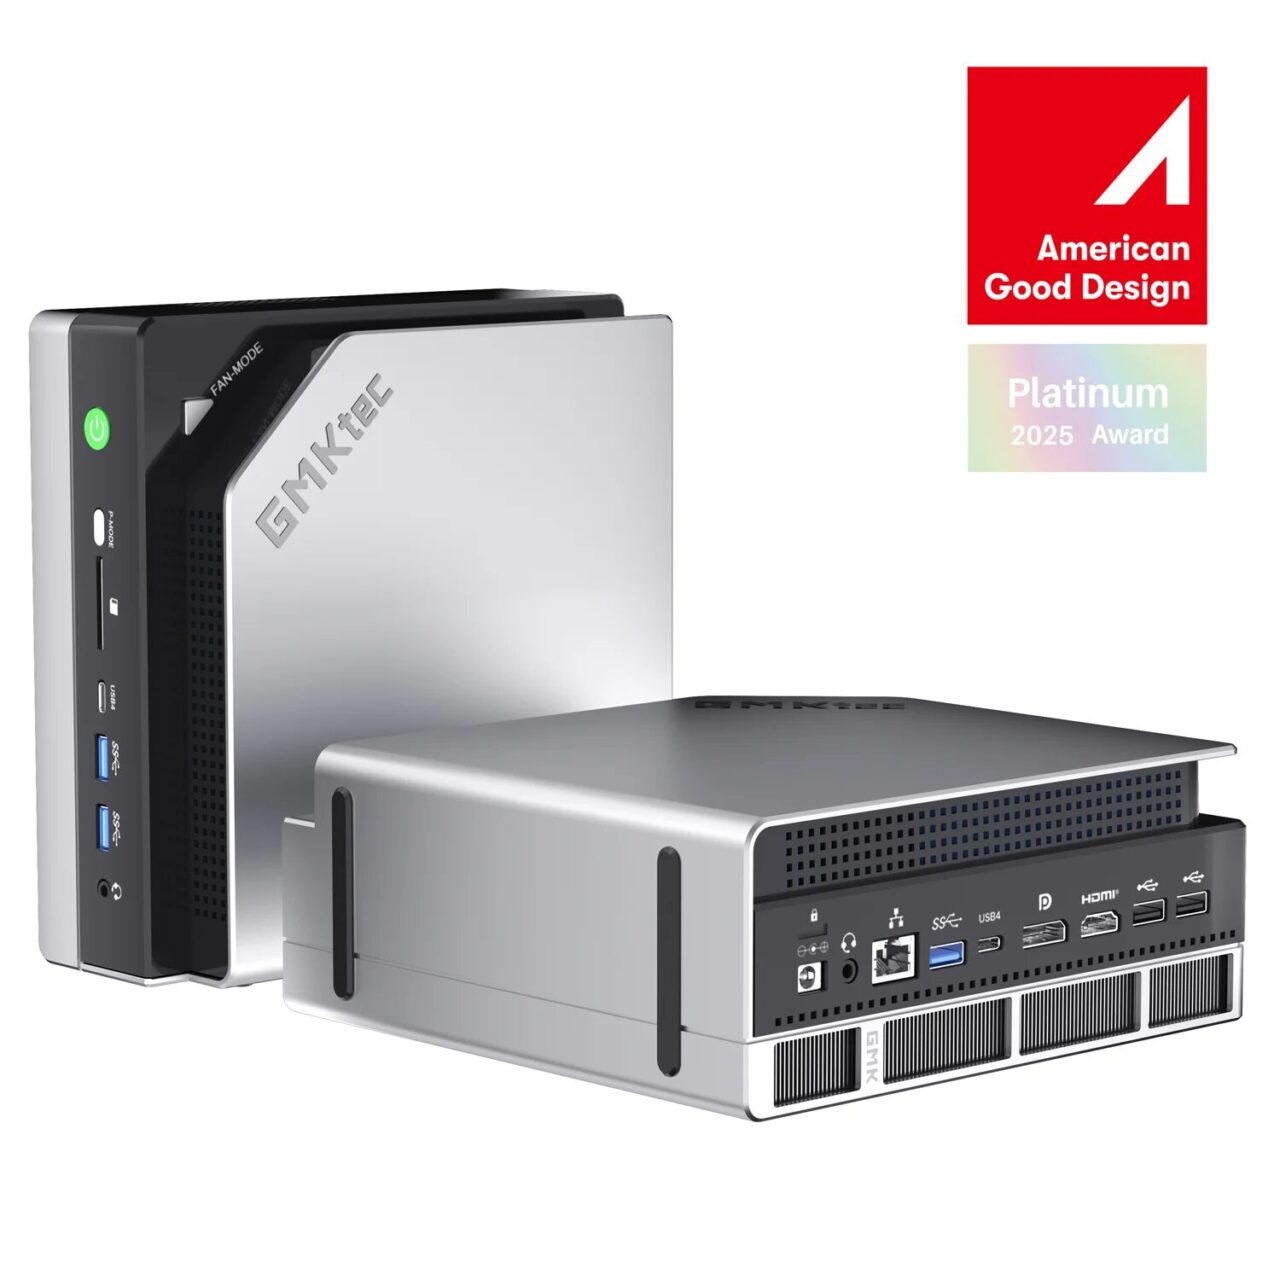
機体は GMKtec EVO-X2(Ryzen AI Max+ 395・メモリ128GB)で、内蔵GPU の Radeon 8060S を使いました。ソフトは llama.cpp の公式ビルド b11192 の llama-bench です。Ollama が保存した blob(/usr/share/ollama 配下などの sha256- で始まるファイル)を、そのままモデルとして渡し、読ませる速さ(pp512)と書く速さ(tg128)を5回ずつ測りました。並べ替えて上下を1つずつ落とし、中央3点の中央値を採っています。測定は 2026年10月3日です。
読めなかった7本と、読めた14本
22本のうち、14本は5回の測定まで通り、1本(qwen3-235b-q2)は1回目の後に読み込みが止まり、7本は最初から「failed to load model」で止まりました。
| 読めなかった7本 | 家族 | 読めた14本の例 |
|---|
| gemma4:31b | Gemma 4 | qwen3:8b・qwen3:14b・qwen3-coder:30b |
| qwen3.6:27b・qwen3.6:35b-a3b | Qwen3.6 | nemotron-3-nano:30b・phi4-mini |
| qwen3-coder-next | Qwen3 Coder Next | llama3.3:70b・minimax-m2.7 |
| gpt-oss:120b | gpt-oss | llama3.2:1b・llama3.1:8b |
| nemotron-3-super:120b-a12b | Nemotron 3 Super | ornith-1.5:9b・35b |
| glm-4.7-flash:Q4_K_M | GLM 4.7 Flash | qwen3:4b・qwen3:1.7b |
読めなかった7本は、ファイルの大きさも家族もばらばらです。18GB の gemma4:31b も、80GB の Nemotron 3 Super も同じエラーでした。容量の問題ではありません。
読めた側の数字も載せておきます。同じ日に、同じ条件で5回の測定が通った14本です。tg128 は128トークンを書かせたときの、pp512 は512トークンを読ませたときの、1秒あたりのトークン数です。
| モデル(Ollama の名前) | ファイル [GiB] | 書く速さ tg128 [tok/s] | 読ませる速さ pp512 [tok/s] |
|---|
| llama3.2:1b | 1.2 | 160.8 | 8,920 |
| qwen3:1.7b | 1.3 | 148.5 | 5,305 |
| phi4-mini | 2.3 | 79.9 | 2,543 |
| qwen3:4b | 2.3 | 77.0 | 2,441 |
| nemotron-3-nano:4b | 2.6 | 71.6 | 2,268 |
| llama3.1:8b | 4.6 | 45.6 | 1,379 |
| qwen3:8b | 4.9 | 41.1 | 1,183 |
| ornith-1.5:9b | 5.4 | 38.7 | 1,132 |
| qwen3:14b | 8.6 | 24.3 | 715 |
| qwen3-coder:30b(MoE) | 17.3 | 91.1 | 1,544 |
| ornith-1.5:35b(MoE) | 20.2 | 75.5 | 1,452 |
| nemotron-3-nano:30b(MoE) | 22.6 | 69.0 | 1,570 |
| llama3.3:70b | 39.6 | 5.3 | 148 |
| minimax-m2.7(MoE) | 101.0 | 28.9 | 260 |
書く速さの目安は、日本語なら 1 tok/s がおよそ1〜2文字です。llama3.3:70b の 5.3 tok/s は人が読む速さを下回り、MoE の3本(30〜35B)は 70〜90 tok/s と、4B 級と同じ速さで動いています。
GGUF の頭を読むと、何が入っているか分かる
GGUF はファイルの先頭に、モデルの種類(architecture)や層の数などの「見出し」を持っています。読めなかった2本の見出しを、Python で先頭だけ読んでみました。
| ファイル | architecture | 見出しにあった項目 |
|---|
| gemma4:31b の blob | gemma4 | gemma4.block_count のほかに、gemma4.vision.block_count(画像用の層の数) |
| qwen3.6:27b の blob | qwen35 | qwen35.block_count のほかに、qwen35.vision.block_count |
どちらも、文章用の本体と、画像を読むための部分(視覚エンコーダ)が1つのファイルに同居していました。llama.cpp 本流では、画像用の部分は mmproj という別ファイルに分けて持つ決まりです。Ollama は自社のエンジン向けに、本体と画像用を1つにまとめた形で配っています。本流の llama.cpp は、この同居した見出しを知らないので、読み込みを止めます。
背景を少し補います。Ollama は 2025年に、llama.cpp をそのまま使う方式から、Go 言語で書いた自前のエンジンへ移りました。Gemma・Qwen・Llama などの構造をエンジン側で直接実装し、画像を扱う部分も同じエンジンの中にあります。Ollama の公式ライブラリで配る画像対応モデル(Gemma 4・Qwen3.5 系など)は、この自前エンジンを前提に、視覚用の重みを本体の GGUF に埋め込んでいます。Ollama の GitHub の issue(ollama/ollama #14730「unknown model architecture: qwen35moe when loading imported GGUF with mmproj」)でも、「公式の qwen3.5:35b は本体の GGUF に qwen35moe.vision の重みを持つため、別ファイルなしで画像が使える」と説明されています。自前エンジンへの移行は Ollama 公式ブログ「Ollama’s new engine for multimodal models」(2025年)が出所です。
読めなかった7本のうち、ファイルの見出しまで確かめたのは gemma4:31b と qwen3.6:27b の2本です。残る5本(gpt-oss・Nemotron 3 Super・Qwen3 Coder Next・Qwen3.6 35B-A3B・GLM 4.7 Flash)は同じエラーでしたが、見出しは読んでいません。原因が同じかどうかは、この記事では断定していません。 当ブログの9月24日の記録では、古いビルド(b10941)で gpt-oss の blob は「gptoss という形式名が未対応」、Nemotron は「重みの形が合わない」というエラーでした。視覚の同居とは別の理由の可能性があり、b11192 で同じかは確かめていません。
読めた14本は、文章だけのモデルか、画像用の部分を含まない形で配られているものでした。同じ「GGUF」でも、中の約束事がエンジンごとに少し違う、ということです。
Hugging Face で配られる GGUF なら読める
同じモデルを、Hugging Face で配られている GGUF(unsloth・ggml-org)に替えて、同じ llama-bench で測りました。4本とも読めて、5回の測定が通りました。書く速さは、日本語なら1秒に 10〜60文字ほどの目安です。
| モデル | 入れ物 | ファイル [GiB] | 書く速さ [tok/s] | 読ませる速さ [tok/s] |
|---|
| Gemma 4 31B | unsloth Q4_K_M | 17.1 | 11.6 | 327 |
| Qwen3.6 27B | unsloth Q4_K_M | 15.7 | 12.6 | 350 |
| Qwen3.6 35B-A3B | unsloth UD-Q4_K_M | 20.6 | 62.7 | 1,423 |
| gpt-oss 120B | ggml-org MXFP4 | 59.0 | 55.2 | 987 |
機体は GMKtec EVO-X2 の内蔵GPU(Radeon 8060S)、llama.cpp b11192、5回測って上下を1つずつ落とした中央3点の中央値です。残る3本(Qwen3 Coder Next・Nemotron 3 Super・GLM 4.7 Flash)は、この日は Hugging Face 版を取得していません。
入れ物が変わると、速さの数字も変わる
gpt-oss 120B は、9月24日に Ollama で測ったとき(5回・中央3点、当ブログの MiMo の記事)は 37.2 tok/s でした。10月3日に llama.cpp b11192 で測ると 55.2 tok/s です。同じ機体、同じ MXFP4 形式で、1.5倍の差が出ました。ただし Ollama 版のファイルは 60.9GB、Hugging Face 版は 59.0GB と、配布物そのものも違います。読む側から見ると、1秒に書ける文字が 40字前後から 60字前後へ増えた、という違いです。Ollama の中のエンジンの版や、既定の設定(文脈長・バッチ)が違うためと考えられますが、どの要因が大きいかは切り分けていません。
ほかのモデルでも、Ollama と llama.cpp の両方で測った値があります。測った日が違うので参考値ですが、差の出方は一様ではありません。
| モデル | Ollama(2026年7月)[tok/s] | llama.cpp b11192(2026年10月3日)[tok/s] | 差 |
|---|
| qwen3:8b | 39.2 | 41.1 | +5% |
| qwen3:14b | 23.2 | 24.3 | +5% |
| qwen3.6:27b | 12.0 | 12.6(HF 版) | +5% |
| gpt-oss:120b | 34〜37 | 55.2(HF 版・MXFP4) | +50%前後 |
密な(dense)モデルの3本は、この比較では 5% ほどの差でした。7月の値は測定日も設定も違うので、差が無いと言い切る根拠にはなりません。gpt-oss 120B だけが大きく違いました。gpt-oss は MXFP4 という 4ビットの形式で配られており、この形式の計算を llama.cpp がどう扱うかで速さが変わると考えられます。どの要因が効いているかは切り分けていません。
当ブログでは、速さの表に「どのエンジンの、どのビルドで測ったか」の列を持たせています。入れ物をまたいで数字を並べるときは、この列をそろえて読む必要があります。
確かめていないこと
・Ollama 側で同じ7本を llama.cpp 形式に書き出す方法があるか(試していません)
・読めなかった7本のうち5本は、ファイルの見出しを読んでいません(原因が2本と同じかは未確認)
・Ollama と llama.cpp の速さの差(37.2 と 55.2 tok/s)の内訳
・Qwen3 Coder Next・Nemotron 3 Super・GLM 4.7 Flash の Hugging Face 版での速さ
・NVIDIA のグラフィックボードで同じ比較をした場合
まとめ〜「同じ GGUF」でも、入れ物の約束が違う
Ollama の blob が llama.cpp で読めなかった原因は、見出しを確かめた2本については、容量でも版でもなく、画像用の部分を同居させた独自の形でした。残る5本は同じエラーですが、原因は確かめていません。llama.cpp で測るなら、Hugging Face の公式 GGUF を使うのが近道です。速さの数字はエンジンで変わるので、表には必ずエンジンとビルドを添えます。
Hugging Face 版の探し方も書いておきます。Hugging Face で「モデル名 GGUF」と検索し、配布元が unsloth・bartowski・ggml-org・開発元の公式のいずれかであれば、llama.cpp 本流で読める可能性が高い配布です。ファイル名の Q4_K_M が4ビット量子化の標準的な形式で、画像を使いたいときだけ mmproj のファイルを別に取ります。逆に、Hugging Face の GGUF を Ollama で使いたいときは、Ollama 側に hf.co/配布元/リポジトリ名:量子化 の形で指定する入り口があります。
次の行動としては、Ollama で入れたモデルを別の道具で使いたい人は、まず Hugging Face に同じモデルの GGUF があるかを確かめることを勧めます。モデルの選び方は、用途別のまとめにあります。
検証に使用した機材
GMKtec EVO-X2 (Ryzen AI Max+ 395 / 128GB / 2TB)A8限定クーポン「A82608」で5,000円OFF(2026/10/31まで)/公式オンラインストアのクーポン「KANSYA2026」で2,000円OFF(2026/10/18まで)
¥583,000
Amazon・2026-10-04調べ
公式サイトのみ ¥5,000引きクーポン配布中 クーポンコード A82608(2026-10-31まで)

 https://kimono-oyaji.com/local-llm-recommended-models-2026/