前回の記事で、ローカルLLMに長い文章を読ませると、最初の一文字が出るまでの待ち時間が伸びることを書きました。ただ、そのとき測れていたのは両端の2点だけで、あいだの様子は分かりませんでした。
今回は、あいだを埋めるために、入力の長さを7段階に変えて測りました。長さが2倍になれば、待ち時間も2倍になるのでしょうか?
2026年8月時点の実測です。
前回の記事はこちら
使用した機器の概要
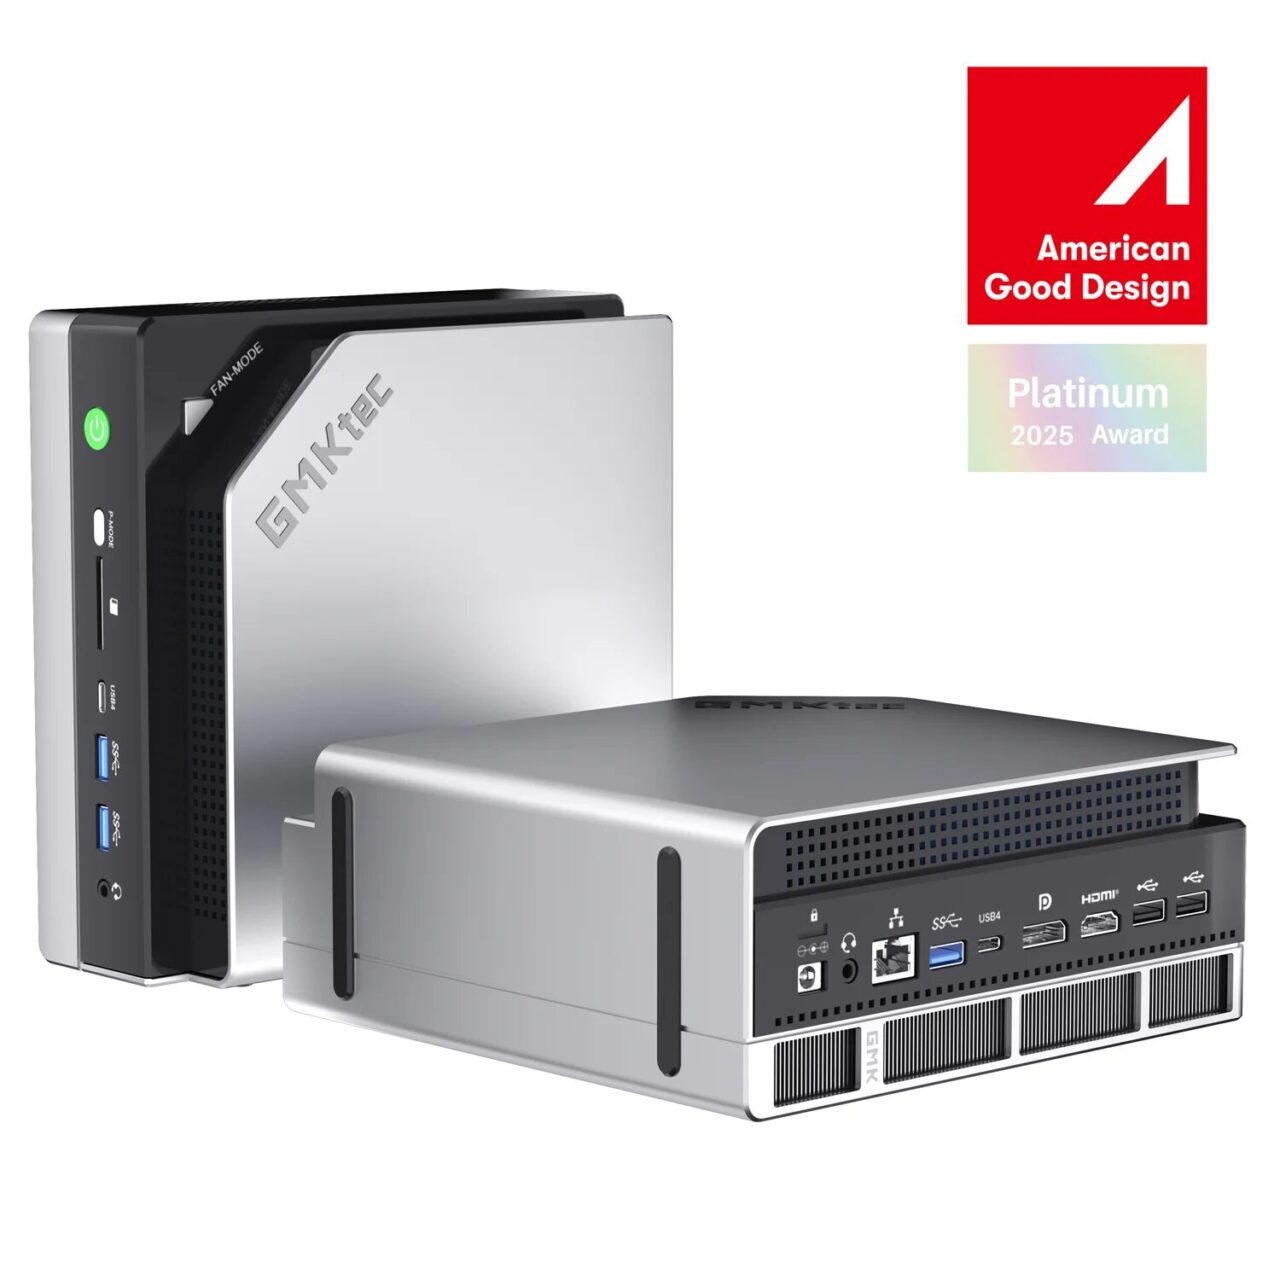
測定に使った本体は、下記のとおりです。前回と同じ組み合わせで測りました。
| 本体 | GMKtec EVO-X2(Ryzen AI Max+ 395 / ユニファイドメモリ128GB) |
| モデル | gpt-oss:120b(65GB・常駐させたまま) |
| 推論エンジン | Ollama 0.30.10 |
| 文脈長 | 131,072トークンを指定 |
| OS | Ubuntu |
何を測ったのか
測ったのは、文章を送ってから、最初の一文字が画面に出るまでの時間です。この時間のほとんどは、送った文章を読み込む処理にあたります。
入力の長さは、約1,100トークンから約67,600トークンまで、7段階に刻みました。トークンというのは文章を細かく区切った単位で、日本語ならだいたい1文字が1〜2トークンです。
どうやって測ったのか
| 測定日 | 2026年8月2日 |
| 回数 | 各7段階を5回ずつ。上下の外れを1つずつ落とし、中央3点の中央値を採った |
| 文章 | 5回とも先頭から違う文章を使った。同じ文章を使い回すと、前回読んだ内容がメモリに残っていて、読み直さずに済んでしまうため |
| 測る値 | モデルの読み込み時間と、送った文章を読む時間の合計 |
| 設定 | 温度0・乱数の種を固定 |
前回の記事で、最初の一文字までの時間には3つの状態があると整理しました。①モデルが載っていない、②載っているがその会話が初めて、③会話が続いている、の3つです。今回測っているのは、このうち
②にあたります。
入力を7段階に刻むと、どんな形になるのか?
結果です。幅は5回測ったときの最小と最大です。
| 入力の長さ | 最初の一文字まで | 5回の幅 | 読む速さ |
|---|
| 約1,100トークン | 1.86秒 | 1.83〜1.95秒 | 725 tok/s |
| 約2,200トークン | 3.50秒 | 3.34〜3.52秒 | 690 tok/s |
| 約4,300トークン | 6.50秒 | 6.47〜6.60秒 | 698 tok/s |
| 約8,500トークン | 13.28秒 | 13.06〜13.37秒 | 659 tok/s |
| 約17,000トークン | 30.27秒 | 30.13〜30.44秒 | 565 tok/s |
| 約35,000トークン | 85.47秒 | 84.74〜86.21秒 | 410 tok/s |
| 約67,600トークン | 313.70秒 | 312.3〜315.4秒 | 216 tok/s |
約67,600トークンで313.70秒、5分を超えています。この間、画面には何も出ません。
5回の幅は、どの段階でも中央値の5%以内に収まりました。測るたびに大きくばらつく数字ではありません。
長さが60倍なら、待ち時間も60倍なのか?
比例にはなりませんでした。
| 比べたところ | 入力 | 待ち時間 |
|---|
| 約1,100 → 約67,600トークン | 60.1倍 | 169倍 |
| 約4,300 → 約35,000トークン | 8.1倍 | 13.2倍 |
前回の記事では、両端の2点から「入力が8倍になると、待ち時間は11倍以上に伸びる」と書きました。今回の8.1倍で13.2倍という結果も、同じ傾向です。
比例より速く伸びる理由は、表の右端に出ています。
読む速さ自体が落ちていくためです。約1,100トークンでは725 tok/s あったものが、約67,600トークンでは216 tok/s と、3分の1以下になりました。
文章が長くなるほど、各トークンが前のトークンとの関係を計算する量が増えます。読む量が増えるうえに、1トークンあたりの手間も増えます。
もしこの読み方が正しければ、読む速さは入力が長くなるにつれて下がり続けるはずです。実際、7段階のうち約2,200から約4,300にかけて690から698へわずかに戻った以外は、最後まで下がり続けました。
同じ文章をもう一度読ませたら、どうなるのか?
上の測定は、5回とも違う文章を読ませています。では、同じ文章をもう一度送ったらどうなるのか。約35,000トークンで、対照として測りました。
| 約35,000トークンの入力 | 最初の一文字まで | 測定回数 |
|---|
| 初めて読ませる | 85.47秒 | 5回 |
| 同じ文章をもう一度 | 0.38秒 | 3回(0.37〜0.43秒) |
225分の1です。読み終えた内容がメモリに残っているため、読み直しがほとんど起きていません。
前回の記事で「2往復目からは2〜3秒に落ちる」と書きました。そのときはエージェントとのやり取りの中で測った値です。文章を用意して測った今回も、同じ結果になりました。
重いのは、長い文章を初めて送るときです。同じ資料を読ませたまま質問を重ねる使い方なら、待たされるのは最初の1回だけです。
前回の「37秒」と、今回の「85秒」
前回の記事と数字が合わないところがあります。
| 入力 | 最初の一文字まで | 読む速さ |
|---|
| 前回(エージェント経由) | 約33,000トークン | 約37秒 | 約900 tok/s |
| 今回(文章を用意して測定) | 約35,000トークン | 85.47秒 | 410 tok/s |
| 前回(エージェント経由) | 約4,000トークン | 2.4〜3.3秒 | 1,219〜1,651 tok/s |
| 今回(文章を用意して測定) | 約4,300トークン | 6.50秒 | 698 tok/s |
同じ本体・同じモデル・同じ推論エンジンで、約33,000〜35,000トークンの点でも、約4,000〜4,300トークンの点でも、2倍前後の開きがあります。
考えられる条件の違いは3つあります。
- 測り方は、前回はエージェントとのやり取りの中で測り、今回は文章を用意して測りました。
- 文脈長は、今回131,072トークンを指定しています。文脈長を大きく取ると、その分の置き場所を先に確保するため、読む速さに影響しうる条件です。
- 前の会話の残りは、前回はやり取りの途中で測っているため、それより前の会話が置き場所に残っていた可能性があります。この記事の3つ目の測定が、その例です。同じ文章をもう一度送ると、約35,000トークンでも0.38秒でした。残っている分は読み直されません。
前回の約900 tok/s は、今回の410 tok/s のおよそ2.2倍です。半分ほどがすでに残っていたとすれば、この開きはおおよそ説明できます。ただ、約4,000トークンの点にも同じ2倍前後の開きがあります。長さに関係なく効く条件(文脈長の指定)の方が、2つの点を同時に説明しやすい候補です。
これは推測で、前回の測定でどこまで残っていたかの記録はありません。この読みが正しければ、会話のいちばん最初の一回だけを測ると、前回も今回と同じくらい遅いはずです。そこでも約37秒で終わるなら、原因は別にあります。
3つのうちどれが原因なのかは切り分けていません。文脈長の影響も未確認です。文脈長だけを変えて測り直すことと、会話の一回目だけを測ること。この2つを次の宿題にします。
この記事の7段階は、すべて同じ条件で測った一組です。段階どうしの比較はそのまま読めますが、
前回の記事の数字と足し引きできる値ではありません。
なぜ、最初の一文字までが長いのか〜読む段階と書く段階
LLM の処理は、送った文章を読む段階(プリフィル)と、答えを1トークンずつ書く段階(デコード)に分かれます。読む段階は計算の量で時間が決まり、書く段階はメモリから重みを運ぶ速さで決まります。最初の一文字までの時間のほとんどは、読む段階です。
読む段階では、文章の中の各トークンが、それより前のトークンすべてとの関係を計算します。文章が長くなるほど、1トークンあたりの相手が増えるため、手間は長さに比例するより速く増えます。この記事で読む速さが 725 tok/s から 216 tok/s へ落ちたのは、この性質によると考えられます。
読み終えた内容は、会話の記憶(KV キャッシュ)としてメモリに残ります。同じ文章をもう一度送ったときに 0.38 秒で済んだのは、この記憶をそのまま使い、読み直さなかったためです。
待ち時間を減らすには〜3つの手
測った結果から、長い資料を読ませるときに待ち時間を減らす手を3つ挙げます。
| 手 | 何をするか | 根拠 |
|---|
| 同じ資料のまま質問を重ねる | 資料を最初に1回だけ送り、以後は質問だけを足す。資料を送り直さない | 同じ文章の2回目は 85.47 秒→0.38 秒(この記事の実測) |
| モデルを降ろさない | Ollama は既定で5分使わないとモデルを降ろし、会話の記憶も消える。keep_alive を長くする | Ollama の公式ドキュメント(keep_alive の設定) |
| 固定の文を先頭に置く | 毎回同じ指示文は先頭に、変わる部分は後ろに置く。先頭が1文字でも違うと、記憶は使われない | llama.cpp のサーバーの「共通の先頭部分だけ再利用する」仕様(cache_prompt) |
llama.cpp のサーバーには、先頭が一致した分だけ読み直しを省く cache_prompt という設定があります(既定で有効)。途中の差し込みにも対応する cache-reuse という設定も別にあります。Ollama も同じ仕組みを内側に持っており、モデルが載っている間は、先頭が一致する入力の記憶を使い回します。当ブログで確かめたのは Ollama での「同じ文章の2回目」だけで、llama.cpp 側の設定の効き目は測っていません。
機体が変わると、読む速さはどう変わるか〜参考値
読む段階の速さは、GPU の計算力で変わります。当ブログの他の実測(短い入力・pp512)を参考に並べます。この記事の gpt-oss:120b とはモデルも入力の長さも違うので、傾向を見るための参考値です。
| 機体 | Qwen3 8B の読む速さ [tok/s] | Qwen3.6 27B の読む速さ [tok/s] | 測った時期 |
|---|
| RTX 3090(24GB) | — | 590 | 2026年7月 |
| EVO-X2 内蔵GPU(Radeon 8060S) | 1,237 | 270 | 2026年7月 |
| Intel Arc B580(12GB) | 1,090〜1,193 | — | 2026年7月 |
| Mac mini(M4・24GB) | 623 | 60 | 2026年7月 |
27B で比べると、RTX 3090 は EVO-X2 の内蔵GPUの2倍ほど、Mac mini は EVO-X2 の内蔵GPUの4分の1ほど(RTX 3090 の10分の1ほど)の読む速さでした。この記事の 313 秒(約67,600トークン・gpt-oss:120b)が、機体によってどこまで縮むかは、同じ条件で測っていません。
この記事で確かめていないこと
- 文脈長の指定を変えたときに、読む速さがどう動くか。前回との差がここから来ているのかどうか
- 他のモデルでも同じ形になるか。今回測ったのは gpt-oss:120b の1本だけです
- 7段階のうち約1,100と約2,200の2点は、測定の記録に付いている状態の札が他の5点と違っています。読む速さは他の5点と同じ並びに乗っているため、測り方の記載に従って同じ扱いにしました
- 約67,600トークンより長い入力。この機体とモデルでどこまで伸びるのかは測っていません
まとめ〜入力を刻んで分かったこと
- 入力が60倍になると、最初の一文字までは169倍に伸びた。素直な比例にはならない
- 伸び方が比例を超えるのは、読む速さ自体が落ちるため。725 tok/s から216 tok/s まで下がった
- 約67,600トークンでは313.70秒。5分を超えて、画面には何も出ない
- 5回の幅はどの段階でも中央値の5%以内。ばらついて出た数字ではない
- 同じ文章をもう一度送ると、約35,000トークンでも0.38秒。重いのは長い文章を初めて送るとき
- 前回の記事の約37秒とは2倍以上の開きがある。条件の何が原因かは未確認
長い資料を読ませる使い方をするなら、置き場所を変えずに質問を重ねられるかどうかが、待ち時間を左右しました。
本記事の数値は2026年8月時点・当環境(GMKtec EVO-X2+Ollama 0.30.10・gpt-oss:120b・文脈長131,072)のものです。使うモデルや設定が変われば結果も変わります。
ローカルでAIを動かす話は、下のまとめページに集めています。
ほかの機材の実測値は、実測データベースで確認できます。
検証に使用した機材
測定に使った本体です。
GMKtec EVO-X2 (Ryzen AI Max+ 395 / 128GB / 2TB)A8限定クーポン「A82608」で5,000円OFF(2026/10/31まで)/公式オンラインストアのクーポン「KANSYA2026」で2,000円OFF(2026/10/18まで)
¥583,000
Amazon・2026-10-04調べ
公式サイトのみ ¥5,000引きクーポン配布中 クーポンコード A82608(2026-10-31まで)
大きなモデルを載せる場合、置き場所が先に足りなくなります。
NVMe SSD 2TB(PCIe 4.0・モデル保存用)生成した画像や動画で先に埋まる

 大きなモデルを載せる場合、置き場所が先に足りなくなります。
 https://kimono-oyaji.com/ttft-prompt-length-2026/