128GBでも足りない?〜ミニPC4台をつなげて使える Lenovo ThinkCentre X Ultra について調べた
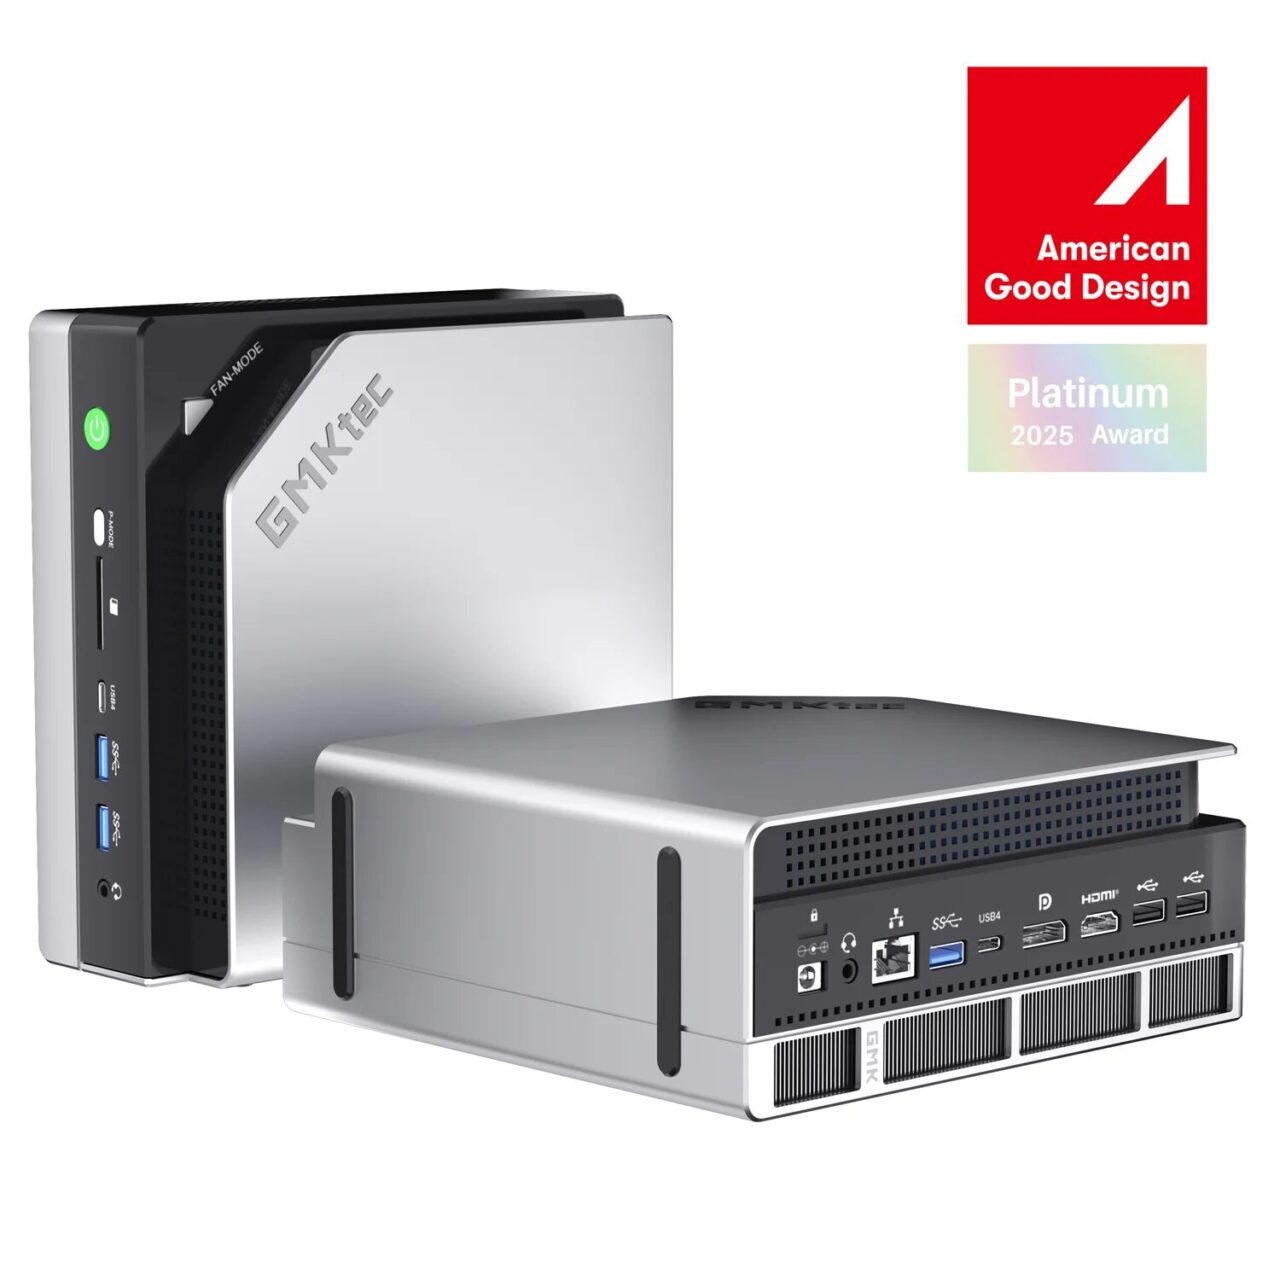
128GBのユニファイドメモリを積んだミニPC、GMKtec EVO-X2(以下、EVO-X2)を持っており、ローカルLLMを動かして遊んでいます。大きなモデルが入るのが特徴ですが、当然128GBより大きなモデルは動かせません。
2026年9月3日、Lenovo が 1.6Lのミニデスクトップ「ThinkCentre X Ultra」を発表しました。同じ128GBを積み、4台つなぐとひとつのまとまりとして扱えると書かれています。この4台は、どのようにしてつながるのか調べたのですが、方式が出てきません。そこで、既存の方式などを調べてみました。
2026年9月時点の調査です。
Lenovo ThinkCentre X Ultra の仕様
Lenovo が9月3日に出したプレスリリースに載っている値です。ミニPCとしては大きめの構成が並びます。
| 項目 | 内容 |
|---|---|
| プロセッサ | AMD Ryzen AI Max+ PRO 495 シリーズまで |
| メモリ | ユニファイドメモリ 最大128GB(LPDDR5X-8533・最大4チャネル・基板直付け) |
| GPUへの割り当て | 最大96GB(ユニファイドメモリから割り当て) |
| ストレージ | M.2 2280 Gen5 SSD ×2(最大4TB×2) |
| 有線LAN | 10GbE RJ-45 ×1 |
| Thunderbolt | Thunderbolt 4(USB 40Gbps)×2 |
| 寸法 | 183×183×51mm(1.6L) |
| OS | Windows 11、Linux AMD AI OS、Ubuntu |
| 価格・時期 | 3,100ユーロから/2026年11月 |
何を調べたのか
次の3つを見て、繋ぎ方がどこまで分かるのかを確かめました。
- Lenovo が9月3日に出したプレスリリース(仕様・価格・時期の一次情報)
- Lenovo の仕様データベース PSREF と、日本のLenovoサイトの製品ページ(掲載されているか)
- 先に同じことをやっている2つの機材の報告(NVIDIA DGX Spark と、同系統のプロセッサを積んだミニPC)
4台で512GB。繋ぎ方は公開されているのか?
プレスリリースでこの機能について書かれているのは、「クラスタ対応の構成で、最大4台をひとつのまとまりとして接続する」という一文だけです。クラスタというのは、複数台のパソコンを繋いで1台のように使う構成のことを指します。4台なら128GB×4で512GBぶんのメモリを持つ計算です。
ところが、どのポートを使うのか、そのときに何Gbps出るのかは、探した範囲では見つかりませんでした。当方が当たったのは、Lenovoのプレスリリース、Lenovoの仕様データベースであるPSREF、日本のLenovoサイトの製品ページ、それに各メディアの記事です。PSREFにはこの製品のページがまだ無く、日本のサイトの製品ページも、2026年9月5日の時点では公開されていませんでした(製品ページのURLが実際にどこへ飛ぶかを確認しています)。メディアの記事も、プレスリリースの一文をそのまま伝えているものばかりでした。
ここから先は、当方の推察です。繋ぎ方が公開されていないので、確かめようがありません。本体に付いている口と、同じことをやっている先行例から、こうではないかと考えた筋を書きます。後でLenovoから説明が出て、違っていた場合は、この記事を直します。
本体にある速い口は2種類〜どちらを使うのかは推察になる
公開されていない以上、本体に付いている口から候補を絞るしかありません。以下は、当方が本体の仕様を見て挙げた候補です。Lenovoがそう言っているわけではありません。
| 候補 | 数 | 4台つなぐと |
|---|---|---|
| 10GbE RJ-45 | 1 | 10GbE対応のスイッチが別に要る |
| Thunderbolt 4(40Gbps) | 2 | 数珠つなぎか輪の形にできる。スイッチは不要 |
Thunderbolt はディスプレイや外付けSSDを繋ぐ口として知られていますが、機器どうしを直結してネットワークとして使うこともできます。2口あるので、隣の機体と左右で手を繋ぐ形にすれば、スイッチを買わずに数台をつなげられます。
Thunderbolt 4 と USB4 は、同じものか
ここで一つ、紛らわしい点があります。X Ultra の仕様には「Thunderbolt 4」と書かれていますが、私が持っているEVO-X2に付いているのは「USB4」です。差し口の形はどちらもUSB Type-Cで、見た目では区別が付きません。
この2つは同じものではありません。Thunderbolt 4 は、USB4 の上に必須条件を足したものです。決めているところも違い、USB4はUSB-IFという業界団体、Thunderbolt 4はIntelが取り仕切っています。
| 項目 | USB4 | Thunderbolt 4 |
|---|---|---|
| 速さの下限 | 20Gbpsでも名乗れる | すべての口で40Gbps |
| PCIeのトンネル | 任意 | 必須(32Gbps以上) |
| 画面 | 1枚が保証 | 4K 2枚、または8K 1枚 |
効いてくるのはPCIeのトンネルです。PCIeというのは、パソコンの内側でグラフィックボードやSSDを繋いでいる通信路のことで、これをケーブルの外まで引き出す仕組みがトンネルです。Thunderbolt 4では必須ですが、USB4では任意になっています。USB4と書かれていても、PCIeが通らない口がありえるということです。そうなると、外付けGPUも、NVMeとして速く読み書きするSSDも動きません。
私が持っているEVO-X2の口については、実測で確かめています。外付けSSDを40Gbpsのケースに入れて繋いだところ、OSからはTRAN=nvmeと見えました。USBの機器ではなくNVMeとして見えているので、PCIeのトンネルが通っています。同じSSDを10Gbpsのケースに入れるとTRAN=usbになり、読み出しは3,716MB/sから1,019MB/sへ落ちました(2026年9月6日の実測)。差し口の形が同じでも、中を通っているものが違います。
確かめ方は2つです。boltctl listでリンクの速さが40Gb/sと出るか、lsblk -o NAME,TRANでnvmeと出るか。カタログの表記ではなく、挿してから見るほうが確実です。
先行例は何で繋いでいるのか
同じことを先にやっている機材が2つあります。どちらも、公称の速さがそのまま出るわけではない、という報告が出ています。
NVIDIA DGX Spark の場合
DGX Spark は2台を繋ぐための専用の口(ConnectX-7・200GbE)を最初から積んでいます。DGX Sparkを2台つないだ第三者の実測記事では、測る層を変えると数字が落ちていくと報告されています。
この記事では、GPUが持っているデータを一度システムメモリに写してからネットワークカードへ渡しているため、その写す手間が挟まると説明されています。専用の口を積んでいても、実際にAIの計算で使える速さは公称の半分以下でした。
Ryzen AI Max+ 395 機の場合
X Ultra と同じ系統のプロセッサを積んだミニPCでは、利用者が自分でクラスタを組んだ報告が出ています。使われているのは USB4/Thunderbolt の直結です。口の公称は 40Gbit/s ですが、Thunderbolt 3のケーブルで繋いだときに出るのはおよそ9Gbit/sと書かれています。上のDGX Sparkの実質値(9〜10 GB/s=およそ80Gbit/s)と比べると、1桁下です。
台数にも制限があります。Linuxのthunderbolt-netには通信を中継する仕組みが無く、2口では3台を直列に並べるところまで。2本をまとめて太くする設定は、カーネルへの修正が取り込まれるのを待っている状態だと書かれています。動かすソフトは llama.cpp の RPC で、片方で rpc-server を動かし、もう片方の llama-server から相手の住所を指定する形です。
X Ultra が4台を謳っている以上、この制限をどう越えるのかは、Lenovoの説明を待つ部分だと考えられます。
AMD 自身が示している場合
いちばん近い先行例は、AMD自身が出していました。2026年2月に公開された手引きで、同じ Ryzen AI Max+ 395 を積んだ機体を4台つなぎ、1兆パラメータのモデルを動かしています。
| 項目 | 内容 |
|---|---|
| 機材 | Ryzen AI Max+ 395・128GBの機体を4台 |
| 繋ぎ方 | 5Gbps の有線LAN(スイッチを1台はさむ形) |
| 動かした道具 | llama.cpp の RPC |
| モデル | Kimi-K2.5(約375GB) |
| 速さ | 9.45 tok/s |
ここで注目したいのは、Thunderbolt ではなく有線LANを使っている点です。しかも5Gbpsで、X Ultra が積む10GbEの半分です。それでも1兆パラメータが動いています。2台版の手引きも公開されていて、そちらは「機体2台とスイッチ1台」という構成でした。
もう一つ、メモリの割り当てについての記述があります。この機体はBIOSの設定ではGPUに96GBまでしか渡せませんが、Linux側の設定で1台あたり120GBまで上げられるとのことです。4台で480GBという計算です。
Mac を並べる場合
同じことを Mac でやっている人たちがいます。こちらは繋ぎ方がはっきりしていて、Thunderbolt で機体どうしを直結する形です。macOSにはThunderbolt Bridgeという機能があり、ケーブル1本でネットワークとして使えます。有線LANを使う例は見当たりません。
2025年12月に公開された分散推論の道具(exo 1.0)は、Thunderbolt 5 の上でRDMAという方式を使い、機体どうしの待ち時間を99%減らしたと発表しています。4台で最大3.2倍という数字が出ています。実際に M3 Ultra の Mac Studio を4台並べた検証では、llama.cpp の従来のやり方(層で割る方式)では台数を足すほど遅くなり、この新しい方式では台数なりに速くなったと報告されています。
ここが先ほどの①と②の話に繋がります。層で割る方式(①)は台数を足しても速くなりませんが、層の中で割る方式(②)は速くなる代わりに、機体どうしで大量のやり取りが要ります。だからThunderboltが要る、という順番です。Mac側の解説でも、Thunderbolt Bridge(40Gbps以上)の使用が強く勧められています。
ノード間の速さは、どこで効くのか?
ここは繋ぎ方より大事なところです。複数台に分けて動かすとき、モデルの割り方が2通りあり、必要な通信量がまるで違います。
手元に置くローカルLLMで使われるのは、多くの場合①です。llama.cpp の RPC も、層で割って隣の機体へ渡す形をとります。①なら台の間を流れるのは1トークンごとの小さな値なので、10GbEでもThunderboltでも足りる可能性があります。むしろ効いてくるのは、1往復ごとに発生する待ち時間のほうだと考えられます。
②を選ぶと話が変わり、口の速さがそのまま結果に出ます。X Ultra が4台でどちらのやり方を想定しているのかは、現時点では公開されていません。
512GBにすると、何が増えるのか
4台で512GBという構成で確実に増えるのは、載せられるモデルの大きさです。128GBに収まらなかったモデルが、収まります。
速さのほうは、増えるとは限りません。①の割り方では、あるトークンを処理している間、担当していない台は順番を待ちます。台数を増やしても1トークンあたりの流れが長くなるだけ、という形です。同時に複数の依頼をさばく使い方なら台数が効きますが、手元で1人が使う場面では、そこは効きにくいところだと考えられます。
費用は、1台3,100ユーロからの機材を4台そろえる形です。費用にはこのほか、10GbEのスイッチと配線が加わります。同じくらいの規模の使い道として、512GBのユニファイドメモリを1台で持つMac Studioという選択肢もあり、こちらは台の間を繋ぐ必要がありません。台数を足して育てられるのがX Ultra、最初から1台で完結するのがMac Studio、という違いだと考えられます。
向いている人、向かない人
| 内容 | |
|---|---|
| 向いている | 1台では入りきらない大きさのモデルを、手元に置いて動かしたい。台数を後から足す形で育てたい。10GbEのスイッチや配線を用意できる |
| 向かない | 1台で足りる大きさのモデルを、少しでも速く動かしたい。配線と設定を増やしたくない。11月まで待てない |
この記事で確かめていないこと
- ThinkCentre X Ultra の実機には触れていません。発売は11月です
- 4台を繋ぐ手順そのものは、Lenovoが公開していないため分かりません。10GbEなのかThunderbolt 4なのかは、本体の口からの推測です
- EVO-X2のUSB4の口は、機器どうしの接続には使っていません。繋いだときに何tok/s出るのかを追試できていません
まとめ〜4台をまとめる口は、調べても出てこなかった
- Lenovo ThinkCentre X Ultra は、1.6Lの筐体に128GBのユニファイドメモリを積み、最大4台をひとつのまとまりとして扱えると発表された(2026年9月3日・11月発売・3,100ユーロから)
- どのポートで繋ぐのかは、調べても出てこなかった。ただしAMD自身が、同じチップの機体4台を5Gbpsの有線LANで繋いだ手引きを公開している。X Ultra も10GbEを1口 積んでおり、有線LANでのクラスタだろう、というのが私の推察
- 先行例では、専用の200GbEの口を積むDGX Sparkでも、実際にAIの計算で使える通信は約10GB/sまで落ちるという実測報告がある
- 同系統のミニPCで組まれたクラスタはUSB4/Thunderbolt直結で実効約9Gbps。経路を中継できず3台までという報告もある
- ただし、モデルを層で割る使い方なら台の間を渡る量は小さく、帯域より1往復の待ち時間が効くと見られる
台数を増やせば置ける、という話は分かりやすい一方で、増えるのは容量で、速さは別の要因で決まります。手元で大きなモデルを動かそうとするとき、最初に頭打ちになるのがメモリの量で、次に来るのが機材どうしを繋ぐ帯域だとすると、ローカルLLMの機材選びは「何GBか」だけでは決められないのではないでしょうか。
そのうえで、繋ぎ方について私が考えていることを書いておきます。有線LANで繋ぐと、Thunderboltを選んでいるMacに比べれば、遅くなるでしょう。それでも、AMD自身が同じチップの機体を4台、5Gbpsの有線LANで繋いで、1兆パラメータのモデルを動かしています。X Ultra が10GbEを1口 積んでいるのは、そのためではないでしょうか。
AMDの発表と同じように、有線LANでのクラスタだと考えられます。ただしこれは私の推察で、Lenovoはまだ何も言っていません。発売は11月です。続報が出たら、この記事に追記します。ウォッチを続けます。
なお、1台で512GBを積める機材について調べた記事はこちらです。

 https://kimono-oyaji.com/mac-studio-m5-ultra-local-llm/
あわせて読みたい

気になる記事があれば、このまとめページから探してみてください。
参考にしたサイト
- Lenovo プレスリリース「Lenovo Advances Hybrid AI for Business with New Think-Family Devices, Displays, and Security Solutions」(2026年9月3日・仕様と価格の出典)
https://news.lenovo.com/pressroom/press-releases/hybrid-ai-for-business-devices-displays-solutions/ - Multimodal Flow「Clustering Two NVIDIA DGX Spark Systems: 200GbE Looks Fast, but NCCL Tells the Real Story」(DGX Spark 2台の実測値の出典)
https://multimodalflow.net/en/blog/dgx-spark-dual-node-nccl-rdma/ - Strix Halo Wiki「Clustering」(USB4/Thunderbolt接続時の実効値と台数制限の出典)
https://strixhalo.wiki/AI/Clustering - ITmedia PC USER「2台のMac StudioをThunderbolt 5で連結! 計128GBメモリ環境と分散推論『exo』でLLMを爆速化してみた」(Macを並べるときの繋ぎ方の出典)
https://www.itmedia.co.jp/pcuser/articles/2604/08/news045.html - exo 1.0 の RDMA over Thunderbolt 5(層で割る方式では台数を足すほど遅くなる、という報告の出典)
https://blog.tumf.dev/posts/diary/2025/12/23/exo-1.0-rdma-thunderbolt5-performance/ - AMD「How to Run a One Trillion-Parameter LLM Locally: An AMD Ryzen™ AI Max+ Cluster Guide」(2026年2月・4台を有線LANで繋いだ構成と 9.45 tok/s の出典)
https://www.amd.com/en/developer/resources/technical-articles/2026/how-to-run-a-one-trillion-parameter-llm-locally-an-amd.html - AMD AI Playbooks「Clustering Two Ryzen™ AI Halos with RPC」(2台構成とスイッチの構成の出典)
https://developer.amd.com/playbooks/clustering-rpc-server/
記事で紹介した機材
比較に使った、手元の128GBのミニPCです。