古いVR180カメラ(Vuze XR)の映像から3Dシーンを作ると、どこまで細かく出るのか〜Spirula Studio で学習回数と設定を比べた
2019年に撮った古いVR180カメラ(Vuze XR)の動画から、3Dの場面を作ったら、どこまで細かく見えるのでしょうか? 今のカメラではない、画素数も小さい素材です。
この記事では、Spirula Studio(動画や写真から3Dシーンを作るソフト)で、京都の東福寺の道を撮った動画(VR180形式・5760×2880)から3Dガウシアンスプラッティング(3DGS)の場面を作り、学習の回数と設定を変えて見え方を比べました。評価は、出力の画素数ではなく、見た目の細かさ(細部の締まり・ぼけ・浮遊物の少なさ)で行っています。
2026年10月18日時点の内容です。測定は、10月18日の朝までに終えています。
目的
- 古い映像(5.7Kクラス)でも、3DGSで「これくらいの解像感が得られる」ことを見せる。
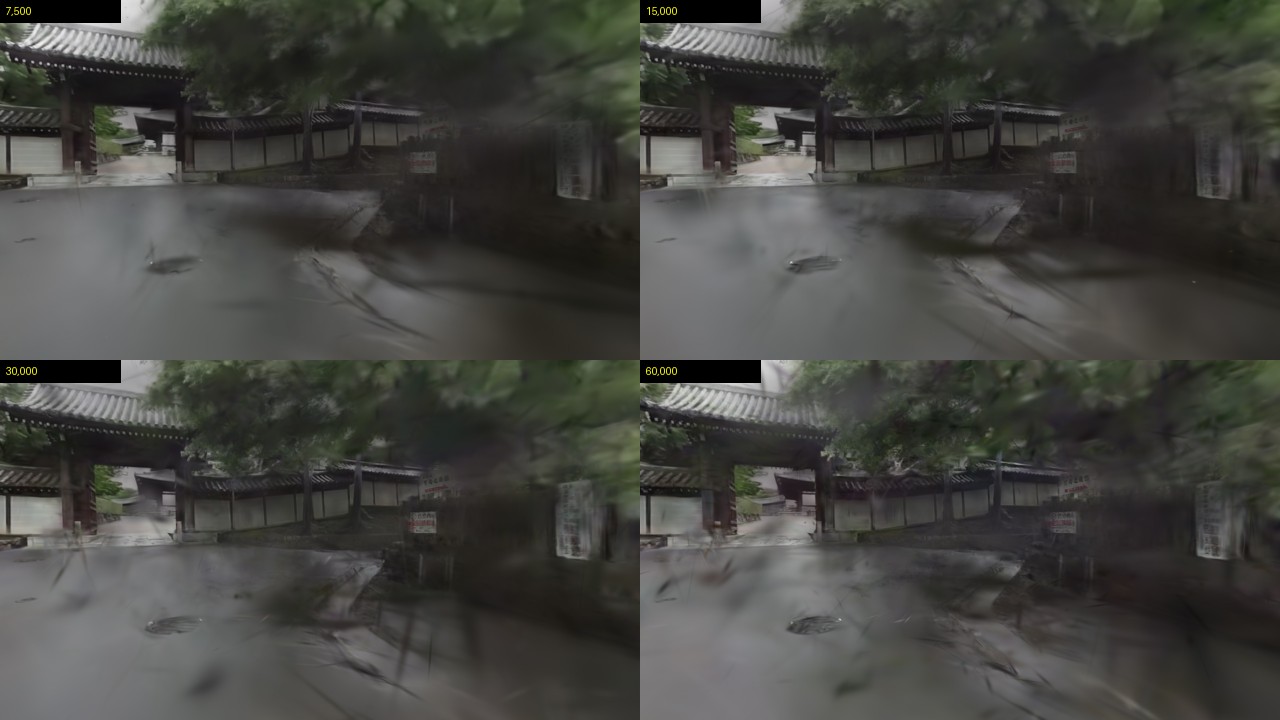
- 学習回数(7,500・15,000・30,000・60,000回)で、どれだけ細かくなるかを見る。
- 設定を1つずつ変えて、細部の締まりと浮遊物(空間に残る「カス」)に影響する設定を探す。
方法
素材は、2019年に撮ったVR180形式(左右並び・5760×2880)の動画の、45秒ぶんです。撮影に使ったカメラは Vuze XR で、撮影時の記録で確かめました。Vuze XR は、360度と180度3Dの両方が撮れる「2in1」のVRカメラで、当ブログの過去記事の比較表では、5.7K(5760×2880)・30fpsで撮れるとしています(Insta360 EVO・Vuze XR・QooCam の比較、Vuze XR の180度3D動画ファイルの形式)。左目の映像(2880×2880)を切り出し、3方向(左60°・正面・右60°)のピンホール画像(画角90°・1280×1280)に変換して、毎秒2枚、計270枚を作りました。人は小さく写る程度で、顔は写っていません。
- ソフト: Spirula Studio 2026.9.24(途中でバージョンは変えていません)。カメラ位置の推定は
sfm auto、学習はtrain 3dgs。 - 機体: EVO-X2(Radeon 8060S・統合メモリ)。1回に1つだけ設定を変えました。
- 描画: 学習済みのデータから、同じカメラ経路で1280×720・30fpsの動画を作りました。経路は、道の向きに沿った直線の前進(高さ一定・視線は進行方向・速さ一定)です。
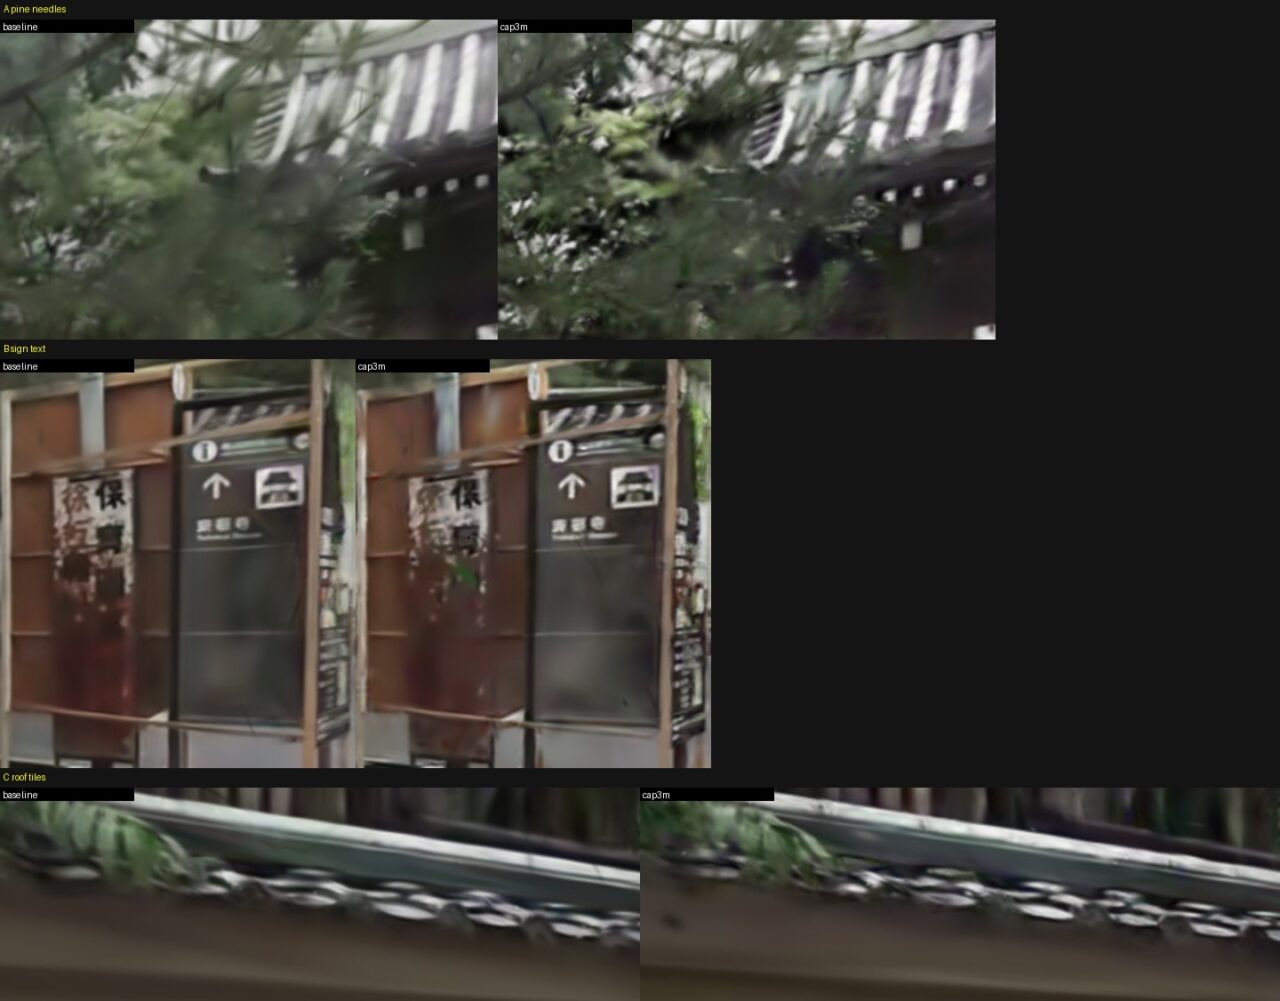
- 見た目の評価: 同じ位置の拡大切り抜き(松の葉・案内板の文字・瓦の縁)を並べて、人の目で比べました。
- PSNRは、学習中の1枚ごとの値の直近30点の平均です。揺れが大きいため、参考値です。素材が違う設定どうしは比べられません。
結果1: 学習回数
| 学習回数 | 学習時間 | スプラット数 | PSNR(参考) |
|---|---|---|---|
| 7,500 | 3分17秒 | 1,000,000 | 22.44 |
| 15,000 | 7分37秒 | 1,000,000 | 23.52 |
| 30,000(既定) | 16分05秒 | 1,000,000 | 25.57 |
| 60,000 | 32分36秒 | 1,000,000 | 25.66 |
30,000回までは、回数が増えるほど見た目が締まります。30,000回から60,000回では、PSNRは25.57から25.66とほぼ変わらず、見た目の差も小さくなりました。時間は2倍です。比較画像(4回数を並べた静止画)と、2×2の動画を付けます。
結果2: 設定を1つずつ変える
| 設定 | 学習時間 | スプラット数 | 見た目 |
|---|---|---|---|
| 背景を学習する空(–background-mode sh) | 16分52秒 | 1,000,000 | 松の葉の拡大では大きな差なし |
| 空をマスクして無視(–apply-loss-for-mask 0) | 18分42秒 | 1,000,000 | 大きな差なし |
| 空をマスクして空扱い(–apply-loss-for-mask 1) | 15分21秒 | 1,000,000 | 悪化。空の部分が黒く抜け、屋根の上の縁が崩れた |
| スプラット上限を300万個(–cap-max 3000000) | 34分29秒 | 3,000,000 | 松の葉・看板の文字の細部が明らかに増える(最も効いた) |
| –quality high | 35分03秒 | 3,000,000 | 上限引き上げと同じ傾向 |
| 素材の切り出しを1920×1920に | 28分56秒 | 1,000,000 | 基準より少し締まるが差は小さい |
| ピンホールの画角を60°に(画素密度が約1.7倍) | 15分49秒 | 1,000,000 | 基準より少し締まるが差は小さい |
| –floater-suppression strong | 18分11秒 | 1,000,000 | 目立つ差なし |
| –densify-score-mode max | 16分36秒 | 1,000,000 | 目立つ差なし |
| –train-resolution-divisor 2 | 10分23秒 | 1,000,000 | 学習は速いが、やや甘い |
最も効いたのは、スプラット数の上限を引き上げることでした。浮遊物を抑える設定(floater-suppression strong)は、今回の素材では目立った効果がありませんでした。
結果3: 最高画質版
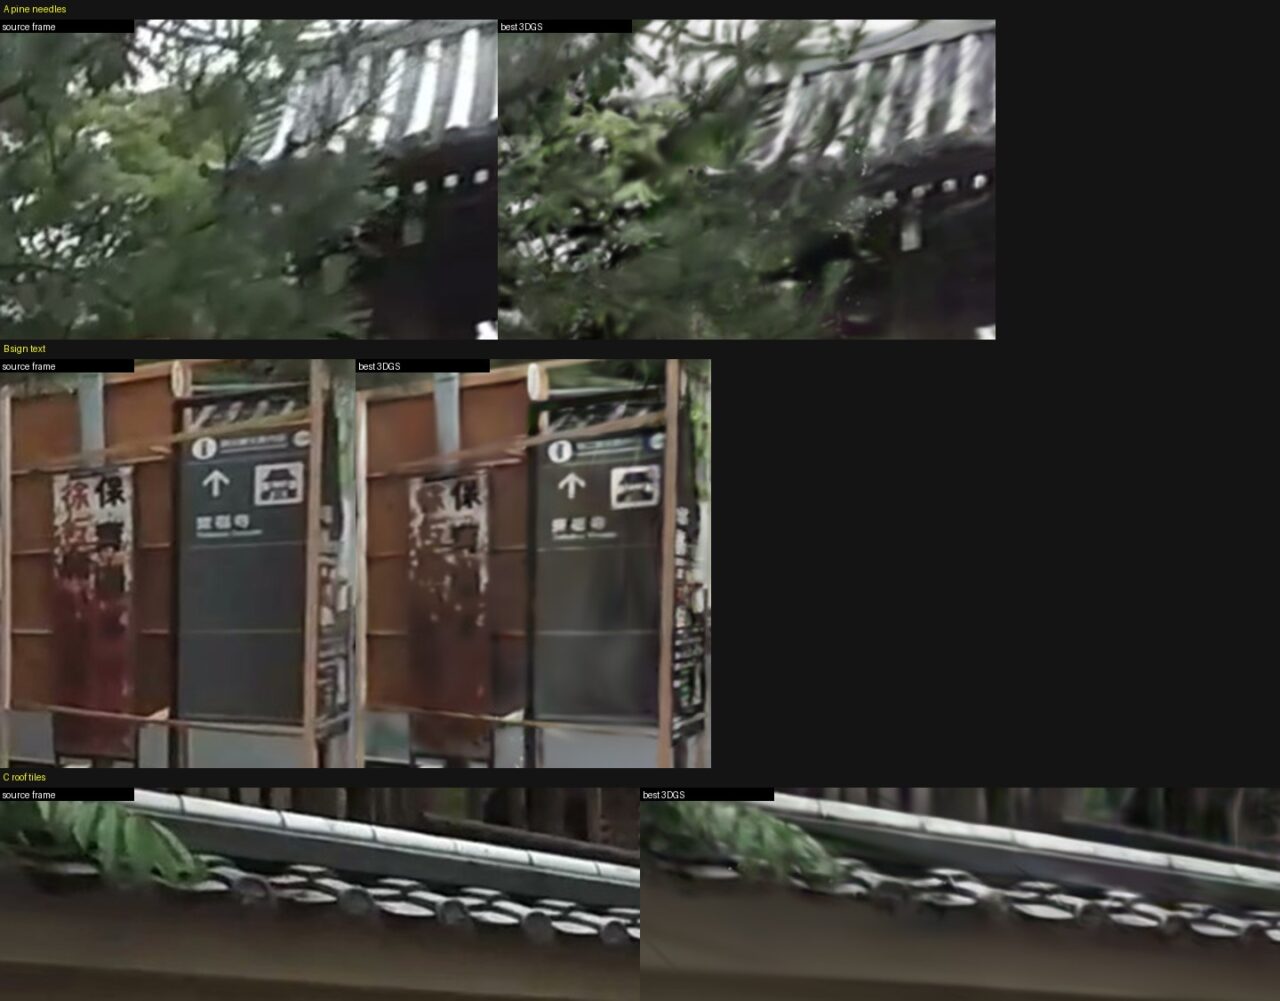
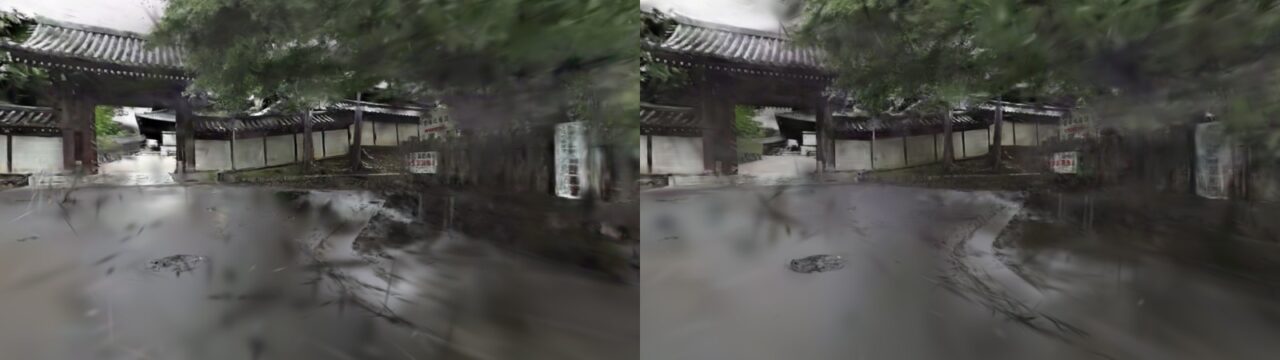
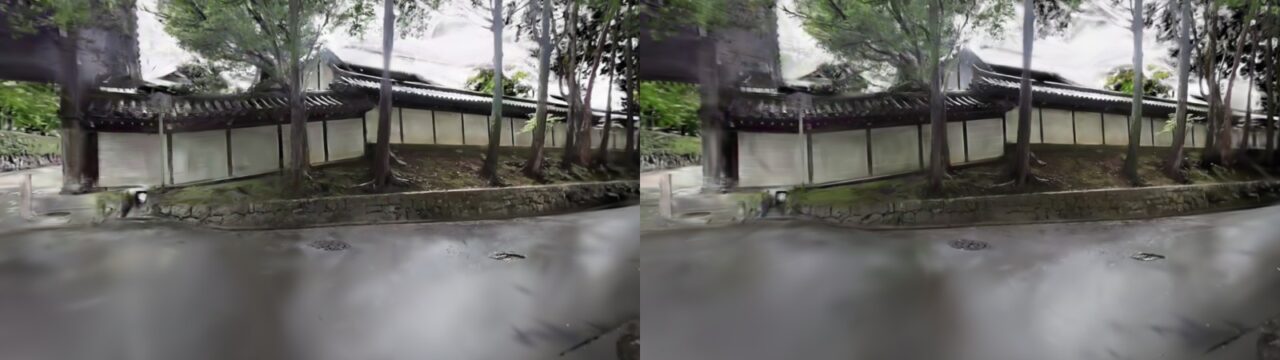
素材を1920×1920、スプラット上限を300万個、--quality highで30,000回学習しました。学習は54分37秒で、ファイルは705MBです。瓦の縁・松の葉は、元の動画のコマに近い細かさまで出ました。案内板の細い文字は元のコマより潰れ、小さな浮遊点が残りました。
結果4: 浮遊物(空間に残るカス)
道路の上に、ぼんやりした影のようなものが残ります。通行人が動いたために、複数の視点で位置が合わなかった跡だと考えています。
- 学習後に、不透明度が低い点・大きすぎる点・撮影位置から遠い点を落とす掃除を試しました。弱い掃除(約13万個除去)では変化がほとんどなく、強い掃除(約110万個除去)では、道路に穴や暗い塊が出て悪化しました。薄い点を削れば消える種類のカスではありませんでした。
- 人の部分をマスクして無視する学習(SAM 3 で人を画像ごとに切り出し)を試しました。270枚のうち114枚に人が写っていて、マスクされる面積は平均0.39%です。
結果5: 人のマスクと、不透明度の正則化
| 設定(最高画質版に追加) | 学習時間 | 見た目 |
|---|---|---|
| 人のマスク(40px拡大)を無視 | 55分35秒 | 道路の黒い筋が減る。暗いぼやけた塊は残る |
| 人のマスク(100px拡大)を無視 | 53分45秒 | 筋はさらに減るが、手前が暗いもやになり悪化 |
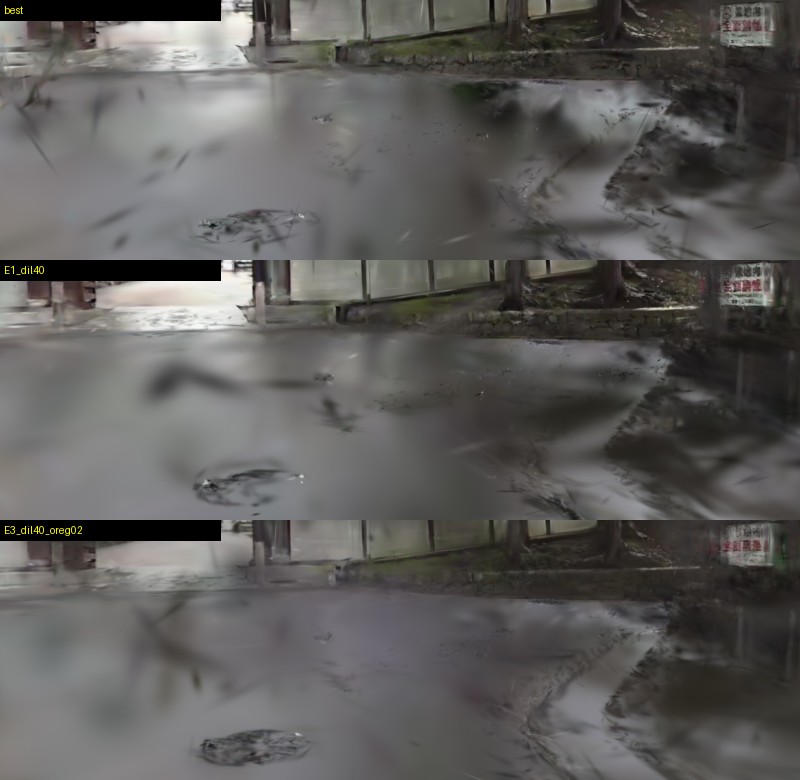
| 40px+opacity-reg 0.02(既定0.005の4倍) | 58分58秒 | 最良。道路の亡霊が大きく減り、マンホールが締まる |
| 40px+opacity-reg 0.05 | 約60分 | 道路は滑らかだが、壁・看板が薄れる |
| 40px+floater-suppression mild | 約60分 | 枝状のぼやけが増え悪化 |
| 40px+opacity-reg 0.02+distraction-robustness mild | 約60分 | E3より暗く、差は小さい |
最も効いたのは、人のマスク(40px拡大)と、不透明度の正則化を既定の4倍にする組み合わせでした。マスクを広げすぎると、その範囲を見ている視点が減り、手前が暗いもやとして残ります。
考察
- 5.7Kクラスの古い動画でも、スプラット数を増やせば、瓦や葉の細部まで出ます。ただし、細い文字は元の画像より潰れます。
- 学習回数は、30,000回で十分でした。回数より、スプラット数の上限のほうが効きました。
- 道路の影の一部は、動く通行人が原因でした。人のマスクで黒い筋は減りました。残る暗いもやは、交差点の路面を撮った視点が少ない(被覆が足りない)ためと考えています。
限界
- 素材は1本、場所は1か所です。他の素材で同じ順位になるとは限りません。
- 見た目の評価は、人の目による比較です。数値の指標は、学習中のPSNR(参考値)だけです。
- 撮影に使ったカメラ(Vuze XR)は、撮影時の記録で確かめました。元の動画ファイルの撮影情報(メタデータ)は、今回は読んでいません。
- 速度や時間は、1回ずつの測定です。
まとめ
古い映像でも、スプラット数の上限を増やし、素材を大きく切り出すと、瓦や葉の細部まで3Dシーンに残せました。一方で、通行人の跡は、学習後の掃除では消えませんでした。人のマスクと不透明度の正則化を組み合わせると、道路の亡霊は大きく減りました。交差点の路面の暗いもやと、細い文字の潰れは残っています。